
Kontingenční tabulky
Kontingenční tabulky
Kontingenční tabulka
V rámci Metody aplikované statistiky navazují kontingenční tabulky na testování statistických hypotéz: místo jedné náhodné veličiny teď sledujeme dva kvalitativní (kategoriální) znaky současně a ptáme se, zda spolu souvisí.
Znak je kvantitativní, pokud nabývá číselných hodnot (stáří, stav tachometru), a kvalitativní (kategoriální), pokud nabývá slovních variant (vzdělání, kuřák/nekuřák). Kvalitativní znaky dále dělíme na alternativní (dvě varianty, např. vada ano/ne) a množné (více než dvě varianty, např. svobodný/rozvedený/ženatý).
Mějme opakování pokusu, při nichž sledujeme dva kvalitativní znaky (varianty ) a (varianty ). Výsledky zapíšeme do kontingenční tabulky: v políčku je simultánní četnost , tedy počet pokusů s variantou zároveň s variantou . Řádkové a sloupcové součty jsou marginální četnosti:
| … | |||||
|---|---|---|---|---|---|
| … | |||||
| … | |||||
| ⋮ | ⋮ | ⋮ | ⋱ | ⋮ | ⋮ |
| … | |||||
| … |
Vydělením četností počtem opakování dostaneme odhady pravděpodobností:
Test nezávislosti dvou kvalitativních znaků
Test ověřuje, zda varianty znaku a varianty znaku jsou na sobě nezávislé, tedy zda simultánní pravděpodobnost je součinem marginálních pravděpodobností.
Postup testu:
- pro všechna , (znaky jsou na sobě nezávislé) proti : znaky jsou závislé.
- Testové kritérium
má asymptoticky Pearsonovo () rozdělení o stupních volnosti. Hodnota je očekávaná četnost políčka — četnost, kterou bychom čekali, kdyby platila. - Kritický obor: .
- Padne-li testové kritérium do , zamítáme na hladině nulovou hypotézu o nezávislosti a přijímáme ; jinak nemáme důvod zamítnout.
V R počítá test i očekávané četnosti funkce chisq.test().
tab1 <- matrix(c(4, 13, 12,
                 31, 62, 71,
                 44, 58, 66,
                 3,  9, 12),
               nrow = 4, byrow = TRUE,
               dimnames = list(
                 vzdelani = c("SS bez maturity", "SS s maturitou nebo VOS", "VS", "ZS"),
                 nakup    = c("ano", "ne, ale planuji", "ne, neplanuji")))
chisq.test(tab1)
chisq.test(tab1)$expected
    Pearson's Chi-squared test

data:  tab1
X-squared = 5.4875, df = 6, p-value = 0.483

                         nakup
vzdelani                        ano ne, ale planuji ne, neplanuji
  SS bez maturity          6.176623       10.696104      12.12727
  SS s maturitou nebo VOS 34.929870       60.488312      68.58182
  VS                      35.781818       61.963636      70.25455
  ZS                       5.111688        8.851948      10.03636
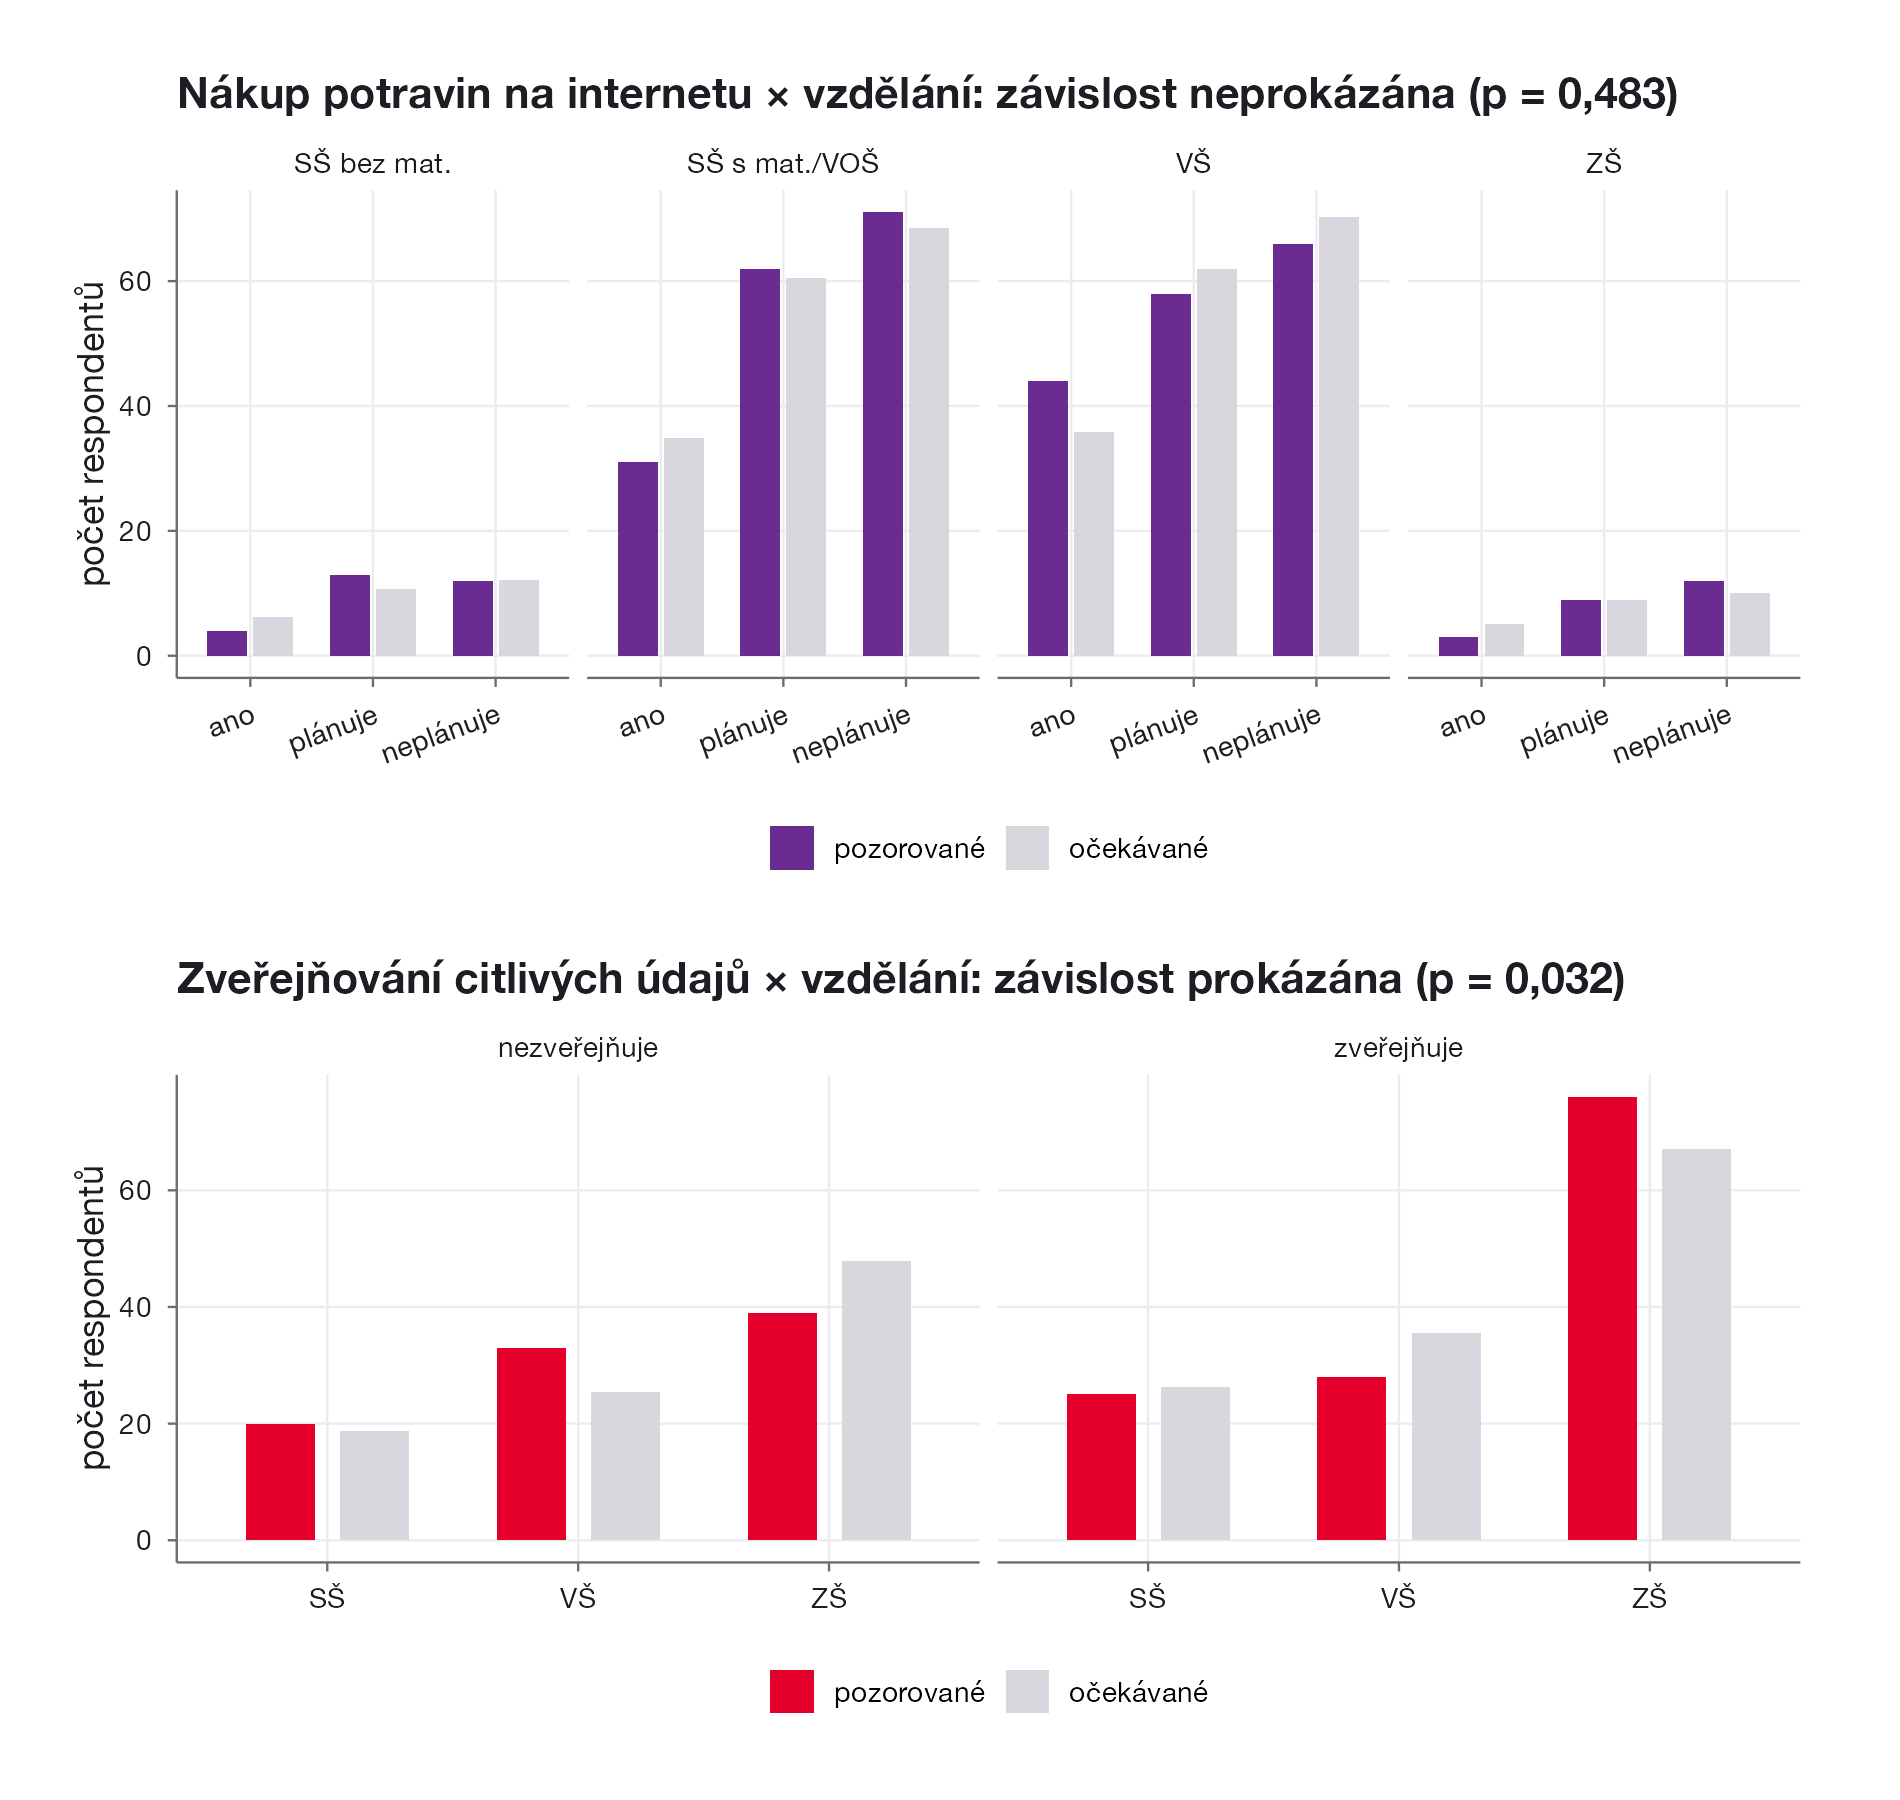
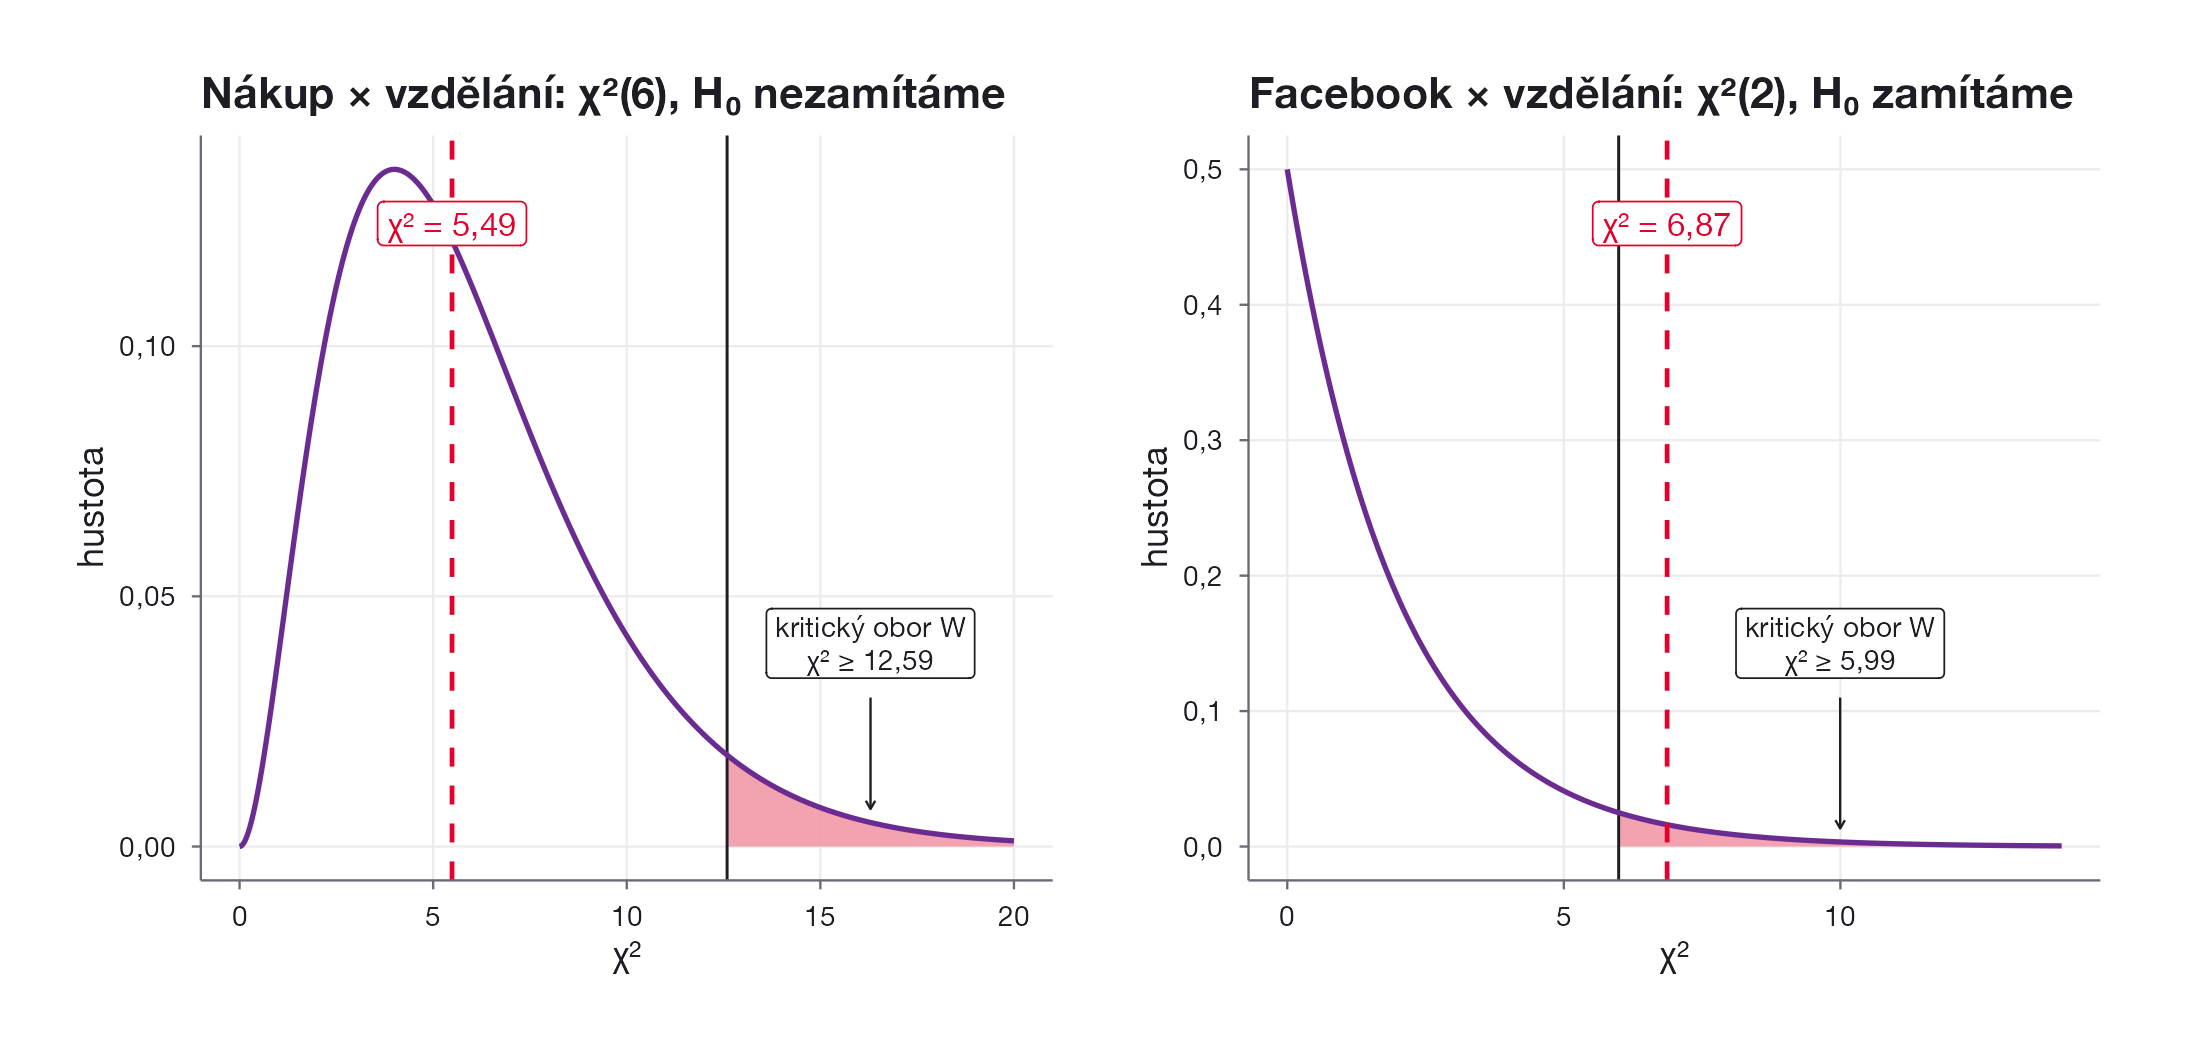
Všechny očekávané četnosti jsou nad 5, aproximace je v pořádku. Testové kritérium s stupni volnosti dává p-hodnotu : nezamítáme, závislost mezi zkušeností s nákupem potravin na internetu a vzděláním respondenta se neprokázala.
tab2 <- matrix(c(20, 33, 39,
                 25, 28, 76),
               nrow = 2, byrow = TRUE,
               dimnames = list(
                 zverejnuje = c("ne", "ano"),
                 vzdelani   = c("SS", "VS", "ZS")))
chisq.test(tab2)
chisq.test(tab2)$expected
    Pearson's Chi-squared test

data:  tab2
X-squared = 6.8677, df = 2, p-value = 0.03226

          vzdelani
zverejnuje       SS       VS      ZS
       ne  18.73303 25.39367 47.8733
       ano 26.26697 35.60633 67.1267
I zde jsou všechny očekávané četnosti nad 5. Testové kritérium s stupni volnosti dává p-hodnotu : zamítáme — na rozdíl od předchozího příkladu tady vzdělání a zveřejňování citlivých údajů na Facebooku na sobě závisí.
Srovnání pozorovaných a očekávaných četností ukazuje, proč jeden příklad nezamítá a druhý ano — ve druhém se pozorované sloupce (zejména u ZŠ) systematicky odchylují od očekávaných, v prvním kolísají jen náhodně kolem nich:
Totéž je vidět na rozdělení testového kritéria: u prvního příkladu leží hluboko pod kritickou hodnotou, u druhého uvnitř kritického oboru :
Cramérův koeficient kontingence
Test nezávislosti pouze rozhodne, zda jsou znaky závislé, nebo ne. Sílu závislosti měří Cramérův koeficient kontingence:
kde je hodnota testového kritéria z testu nezávislosti. odpovídá úplné nezávislosti znaků, jejich úplné závislosti.
V1 <- sqrt(as.numeric(chisq.test(tab1)$statistic) / (sum(tab1) * (min(dim(tab1)) - 1)))
V2 <- sqrt(as.numeric(chisq.test(tab2)$statistic) / (sum(tab2) * (min(dim(tab2)) - 1)))
V1
V2
[1] 0.08441958
[1] 0.1762822
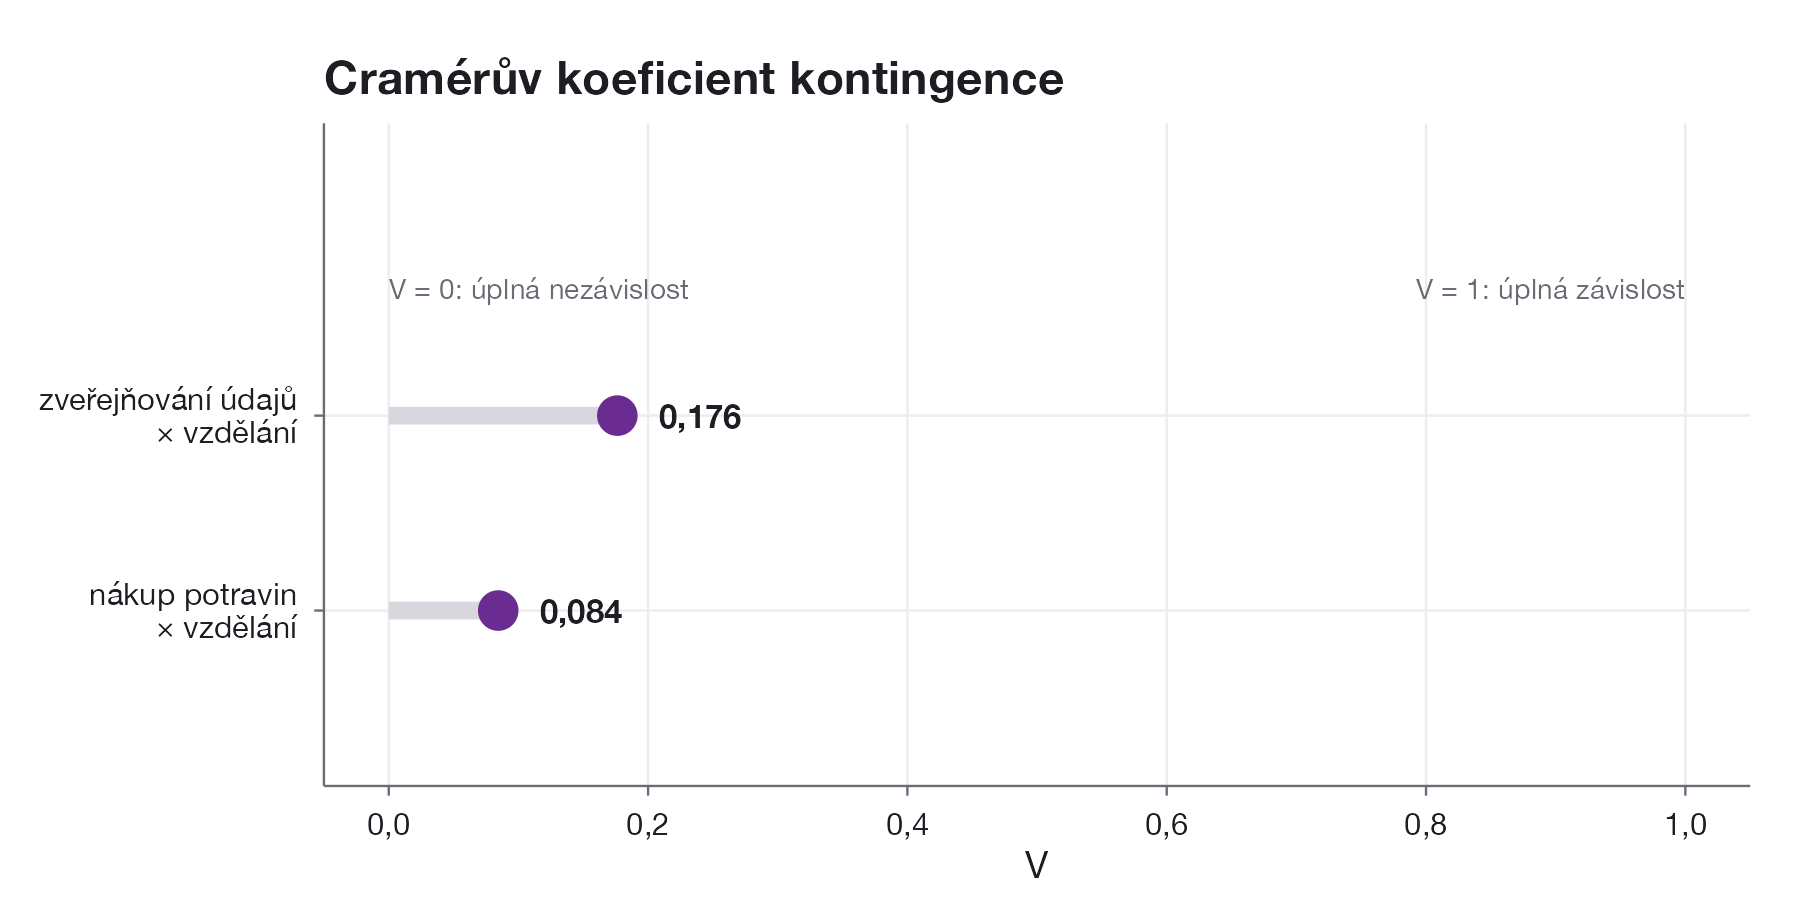
U nákupu potravin je zanedbatelné — ostatně jsme ani nezamítli. U zveřejňování údajů je : jsme zamítli, ale samotná závislost je stále slabá.
Čtyřpolní tabulka
Čtyřpolní tabulka je speciální případ kontingenční tabulky, kdy oba znaky i mají jen dvě varianty ():
Pro se místo obecného vzorce používá zjednodušená varianta testového kritéria:
s kritickým oborem — formálně jde o stejný test
nezávislosti jako výše, jen dosazený do zjednodušeného tvaru pro stupeň volnosti. V R dává tuto hodnotu chisq.test(tab, correct = FALSE). Bez correct = FALSE R u tabulky 2 × 2 použije Yatesovu korekci na kontinuitu a testové kritérium vyjde menší.
McNemarův test
Čtyřpolní tabulka z předchozí sekce porovnává dva různé znaky na stejném souboru. McNemarův test řeší jinou situaci: na prvcích základního souboru se měří jeden alternativní znak, a to dvakrát — před a po nějakém zásahu. Cílem je zjistit, zda zásah změnil pravděpodobnostní rozdělení variant tohoto znaku. Jde tedy o párová data (stejné prvky měřené opakovaně), ne o dva nezávisle naměřené znaky.
Kontingenční tabulka před/po má tvar:
| před \ po | + | − | |
|---|---|---|---|
| + | |||
| − | |||
Pole a jsou shodná (prvek zůstal ve stejné variantě), pole a jsou diskordantní (prvek mezi měřeními variantu změnil) — jen ta rozhodují o výsledku testu:
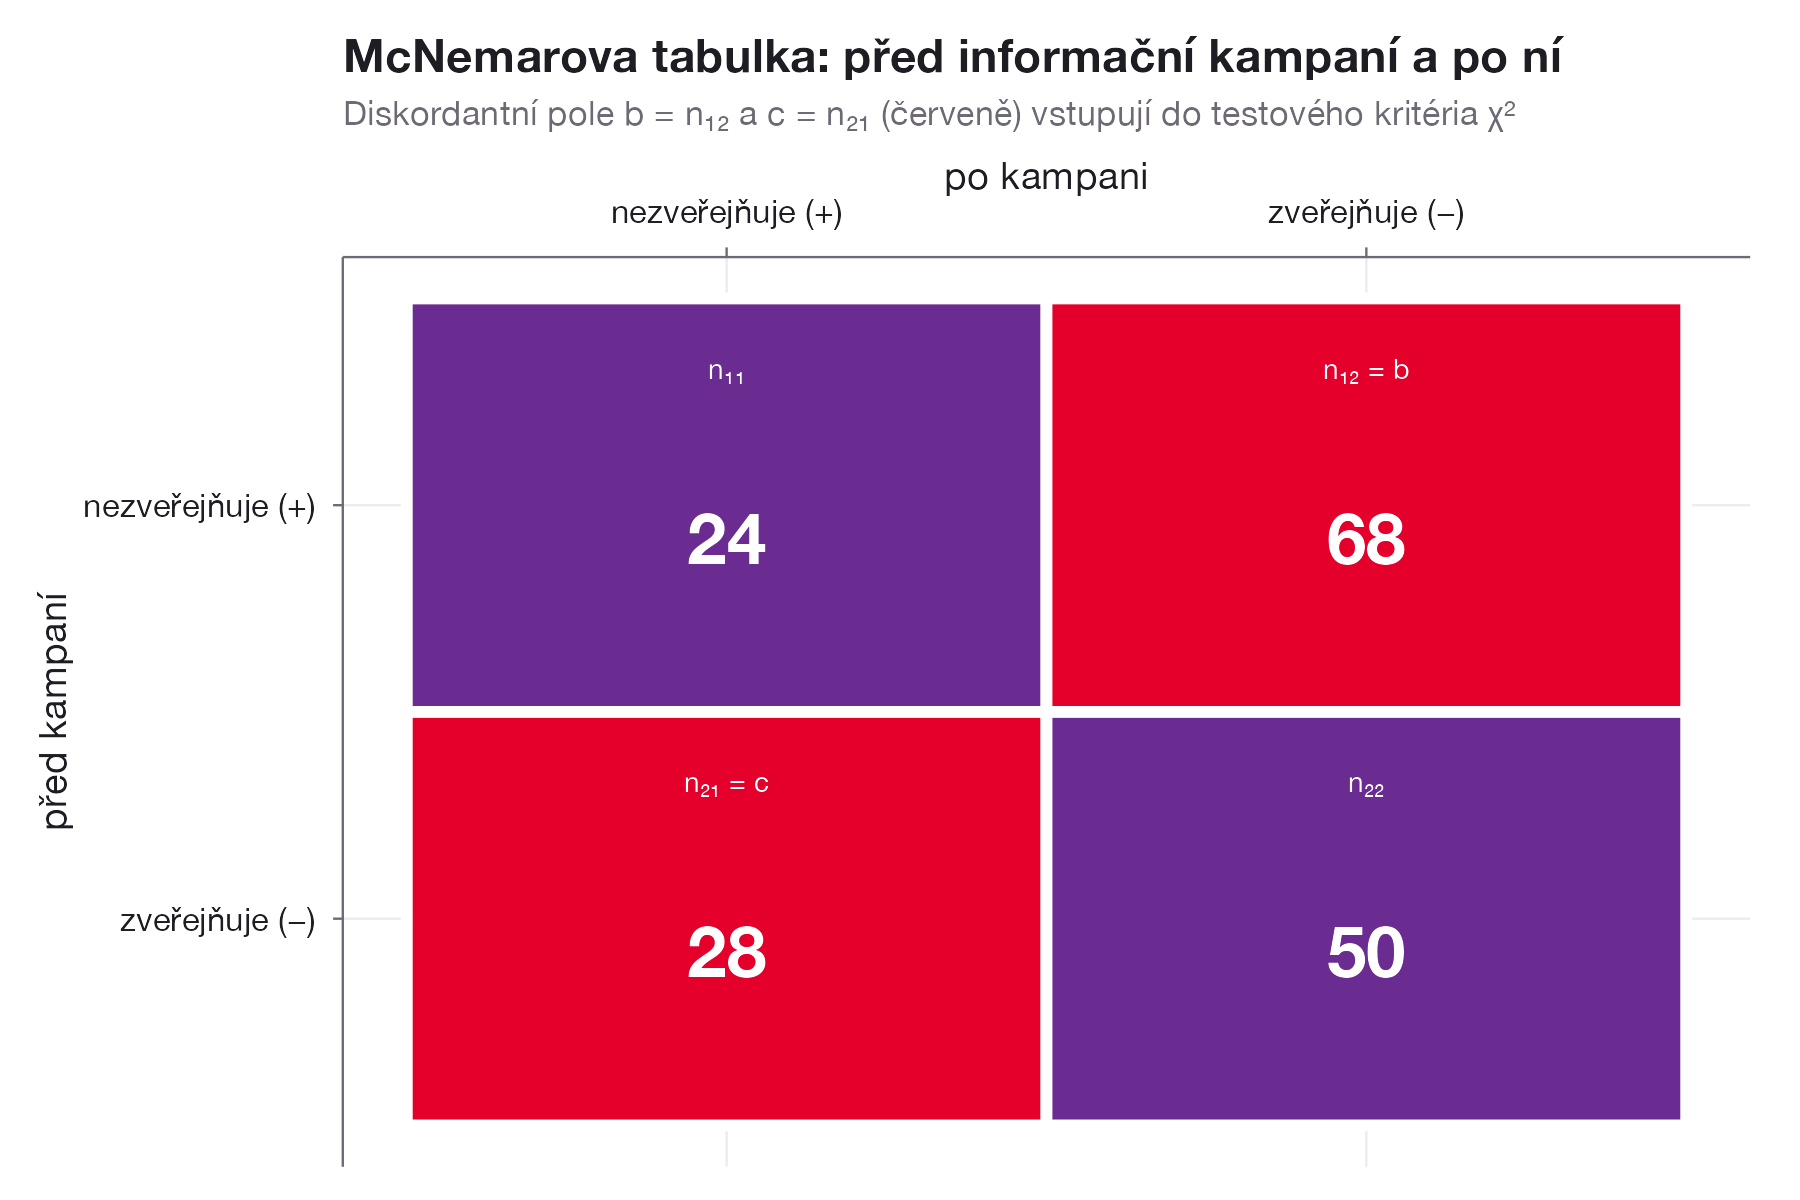
Postup testu:
- — pravděpodobnost přechodu z varianty (+) do (−) je stejná jako pravděpodobnost přechodu z (−) do (+); zásah tedy nemá na rozdělení variant žádný vliv.
- Testové kritérium
má asymptoticky Pearsonovo rozdělení o stupni volnosti. - Kritický obor: .
- Padne-li testové kritérium do , zamítáme a přijímáme : zásah rozdělení variant změnil.
V R počítá tento test funkce mcnemar.test(). Vzorec výše neobsahuje korekci na kontinuitu — aby R vrátilo
přesně tuto hodnotu, musí se volat s correct = FALSE (viz Časté chyby níže).
tab3 <- matrix(c(24, 68,
                 28, 50),
               nrow = 2, byrow = TRUE,
               dimnames = list(
                 pred = c("nezverejnuje", "zverejnuje"),
                 po   = c("nezverejnuje", "zverejnuje")))
mcnemar.test(tab3, correct = FALSE)
    McNemar's Chi-squared test

data:  tab3
McNemar's chi-squared = 16.667, df = 1, p-value = 4.456e-05
P-hodnota : zamítáme, přijímáme — informační kampaň měla vliv na změnu chování studentů ve zveřejňování údajů na Facebooku.
Časté chyby
chisq.test(tab3)
    Pearson's Chi-squared test with Yates' continuity correction

data:  tab3
X-squared = 1.4793, df = 1, p-value = 0.2239
P-hodnota by vedla k nezamítnutí — opačný závěr než správný McNemarův test. Na
párovaná data (stejné prvky měřené dvakrát) vždy patří mcnemar.test(), nikdy chisq.test().
mcnemar.test(tab3)
    McNemar's Chi-squared test with continuity correction

data:  tab3
McNemar's chi-squared = 15.844, df = 1, p-value = 6.879e-05
Oproti nekorigované hodnotě vyjde — v tomto příkladu obě vedou ke
stejnému rozhodnutí, ale u hodnot blíž hranici by korekce mohla rozhodnutí změnit. Aby R reprodukovalo
nekorigovaný vzorec, je třeba vždy volat mcnemar.test(x, correct = FALSE).
Související stránky
- Metody aplikované statistiky
- Testování statistických hypotéz
- Popisná statistika a datové soubory
- Náhodné veličiny a rozdělení pravděpodobnosti
- Regresní a korelační analýza
- Regulační diagramy a indexy způsobilosti
- Tahák pro R
Reference
KROPÁČ, J. Statistika A. 4. vyd. Brno: Fakulta podnikatelská VUT, 2011.