
Testování statistických hypotéz
Testování statistických hypotéz
Testy statistických hypotéz jsou nástroj Metod aplikované statistiky pro rozhodování o parametrech nebo tvaru rozdělení na základě náhodného výběru, nikoli vyčerpávajícího šetření celého základního souboru. Vycházejí z charakteristik, které lze předem spočítat jako popisnou statistiku výběru, a z rozdělení uvedených u náhodných veličin (normální, , ).
Statistická hypotéza a její test
Statistická hypotéza je předpoklad o parametru nebo tvaru rozdělení zkoumaného znaku — například že určitý typ auta má průměrnou spotřebu 7 l/100 km. Ověřit ji na celém základním souboru je obvykle neekonomické nebo technicky neproveditelné, a tak se posuzuje na výběru. Testování hypotéz je proces ověření správnosti nebo nesprávnosti hypotézy pomocí výsledků získaných náhodným výběrem.
Proti sobě stojí dvě hypotézy:
- Nulová hypotéza — tvrzení o parametru nebo rozdělení, které chceme ověřit.
- Alternativní hypotéza — staví se proti a určitým způsobem popírá její tvrzení.
Pro existují tři varianty :
| Tvar | Zápis | Typ |
|---|---|---|
| nerovnost | dvoustranná | |
| větší | jednostranná | |
| menší | jednostranná |
Chyba I. a II. druhu
Protože je úsudek odvozen z náhodného výběru, může vést ke dvěma typům chybného rozhodnutí:
- Chyba I. druhu — zamítnutí , ačkoliv ve skutečnosti platí. Pravděpodobnost .
- Chyba II. druhu — přijetí , ačkoliv platí . Pravděpodobnost .
| Úsudek o | platí | neplatí |
|---|---|---|
| Nezamítá se | správné rozhodnutí, | chyba II. druhu, |
| Zamítá se | chyba I. druhu, | správné rozhodnutí, |
Hladina významnosti je předem pevně zvolená pravděpodobnost chyby I. druhu (klasicky 5 %). Testovací postup je odvozen tak, aby při dané hladině významnosti zajišťoval minimální pravděpodobnost chyby II. druhu.
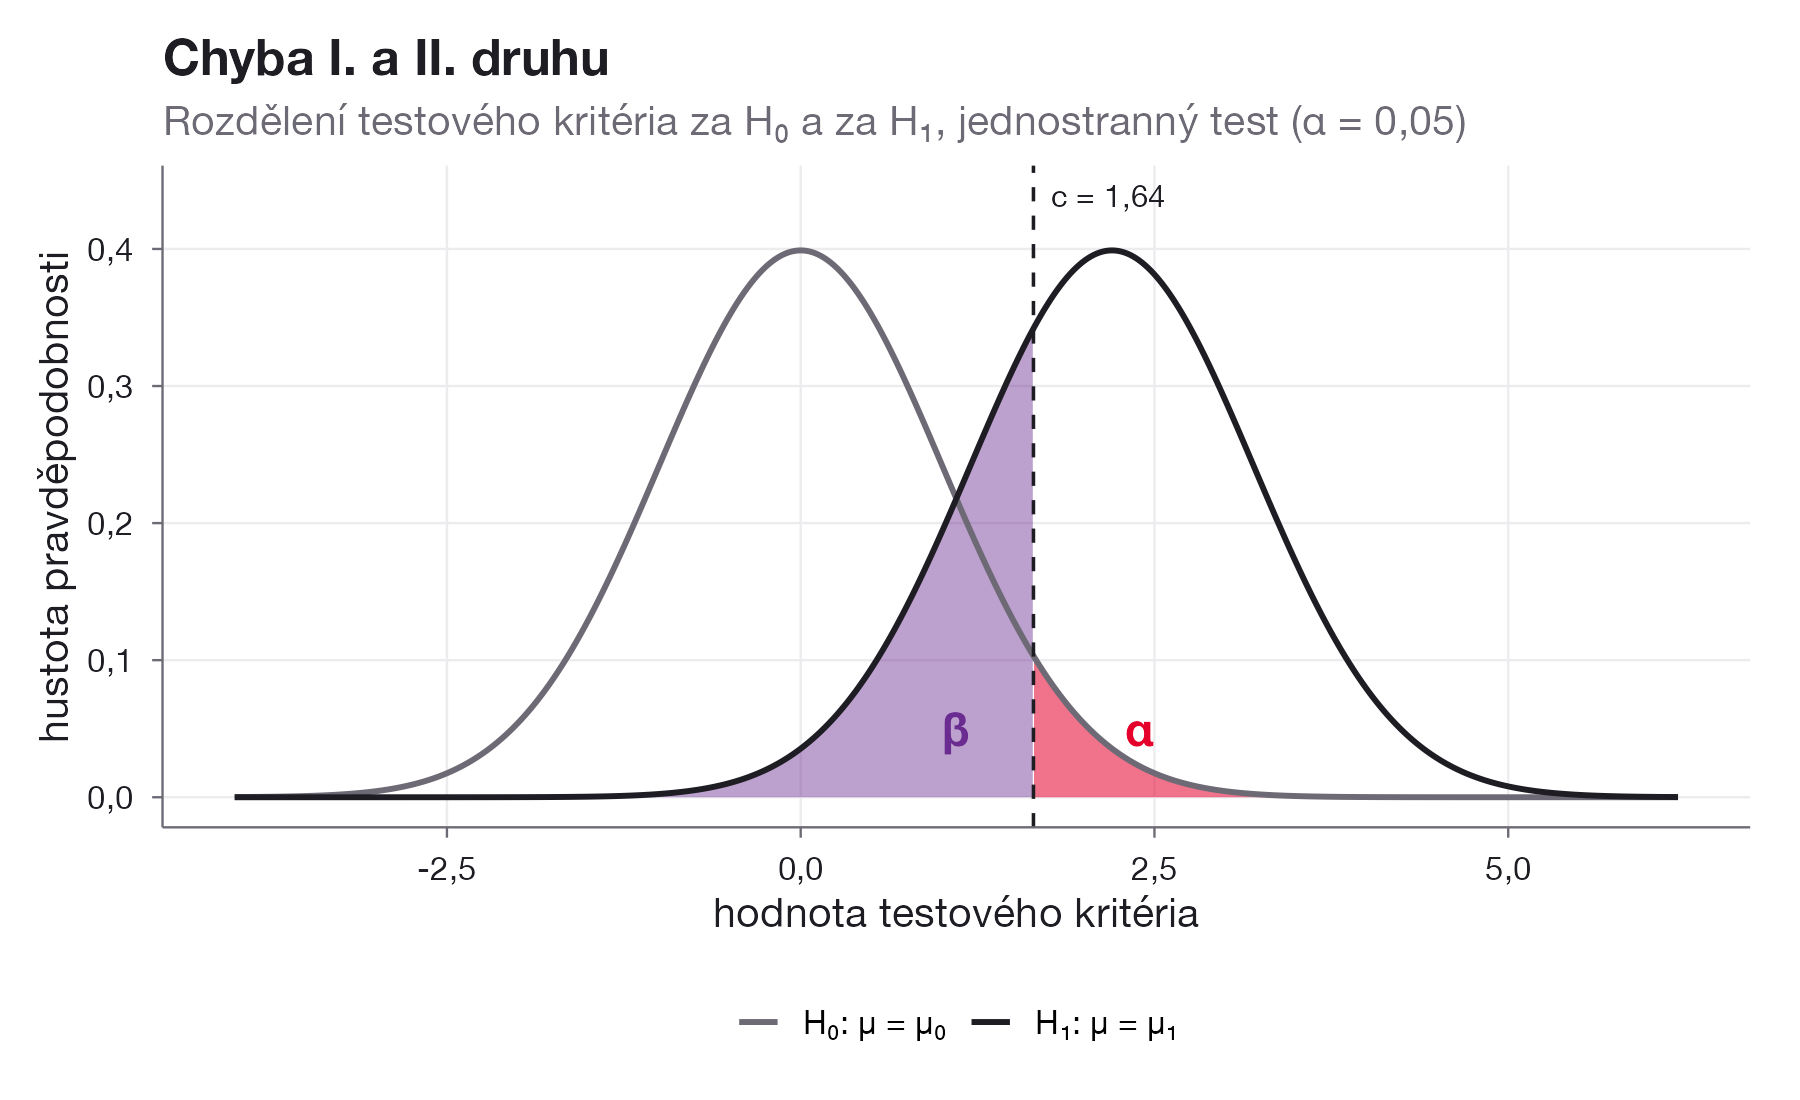
Obrázek ukazuje, proč jde o kompromis: posunutí kritické hodnoty doleva zmenší , ale zvětší , a naopak. Pro danou hladinu je jednoznačně určena rozdělením kritéria za platnosti .
Testové kritérium a kritický obor
Testové kritérium je statistika spočtená z výběru; aby bylo možné test provést, musí být známo jeho rozdělení za platnosti .
Kritický obor je množina hodnot svědčících pro . Je zkonstruován tak, aby
tedy aby pravděpodobnost, že výběr dá hodnotu kritéria v i při platné , byla rovna zvolené hladině významnosti.
Postup testování hypotézy
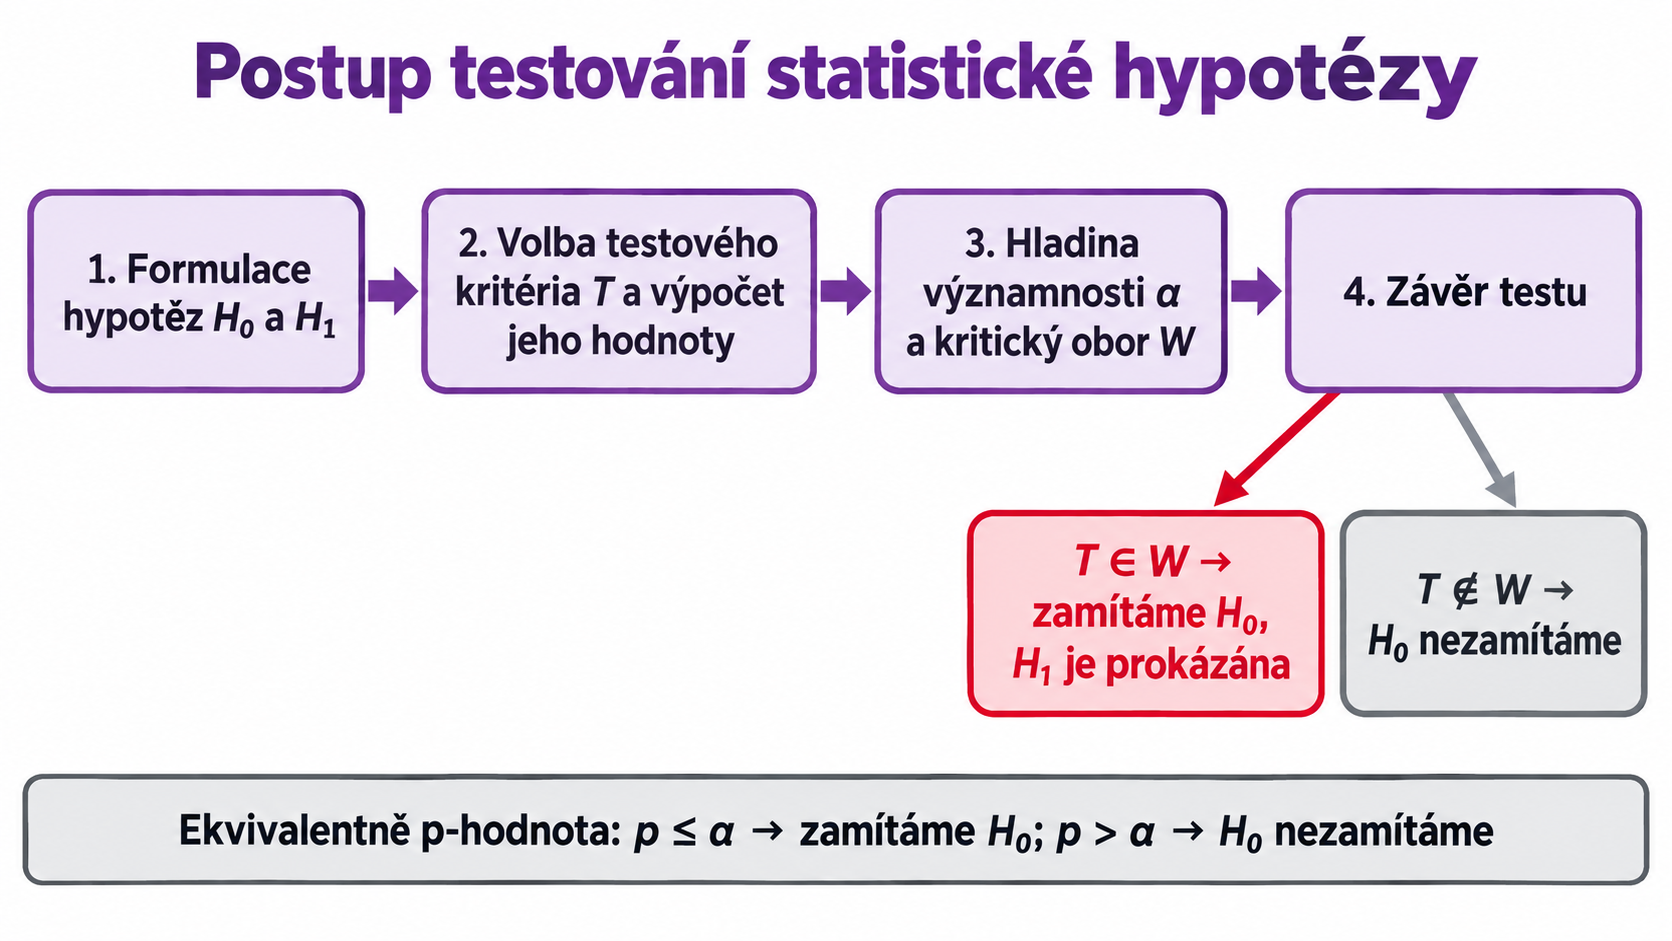
- Formulace hypotéz a .
- Volba testového kritéria a výpočet jeho hodnoty.
- Volba hladiny významnosti a sestrojení příslušného kritického oboru .
- Formulace závěru:
- pokud : je testem prokázána na hladině významnosti (zamítáme );
- pokud : není testem prokázána na hladině významnosti ; nezamítáme.
Rovnocennou alternativou je p-hodnota: udává, nakolik jsou data slučitelná s . Čím menší p-hodnota, tím více data svědčí proti . Rozhodovací pravidlo: zamítáme ; nezamítáme. Obě cesty — kritický obor i p-hodnota — vedou vždy ke stejnému závěru; R u všech testů vrací p-hodnotu přímo.
Jednovýběrový t-test
Test o střední hodnotě rozdělení . Z výběru o rozsahu se určí charakteristiky a ; testem se posuzuje vztah mezi zvoleným číslem a neznámou hodnotou . Testové kritérium
má Studentovo rozdělení o stupních volnosti.
| Kritický obor | ||
|---|---|---|
V R test provádí t.test(). Autobusová linka měla na trase průměrnou dobu jízdy 12 minut; po úpravě trasy se při devíti jízdách naměřily časy v minutách. Ovlivnila úprava trasy dobu jízdy?
x <- c(12.5, 13.5, 11.9, 12.2, 13.0, 14.3, 12.2, 11.8, 14.0)
t.test(x, mu = 12, alternative = "two.sided")
    One Sample t-test

data:  x
t = 2.6685, df = 8, p-value = 0.02843
alternative hypothesis: true mean is not equal to 12
95 percent confidence interval:
 12.11169 13.53275
sample estimates:
mean of x
 12.82222
t je testové kritérium, df stupně volnosti, p-value p-hodnota pro zvolenou alternativu a mean of x výběrový průměr. Zde : úprava trasy průměrnou dobu jízdy (původně 12 minut) statisticky významně změnila.
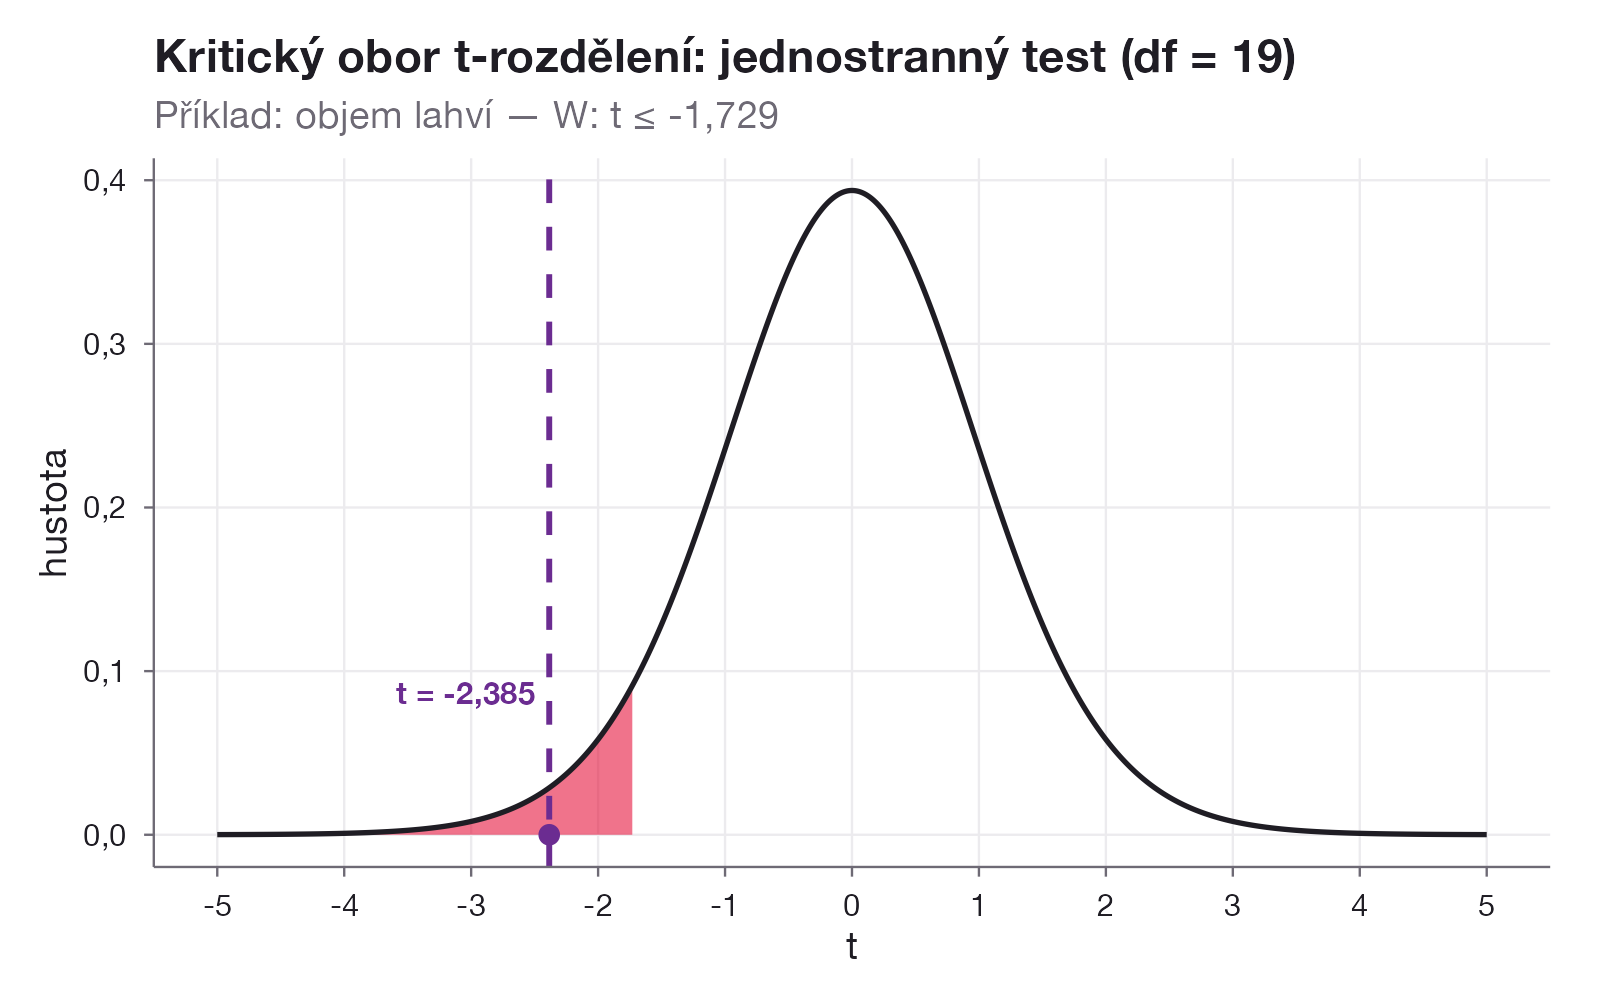
Ze souhrnných charakteristik bez surových dat t.test() spustit nelze — kritérium a kritická hodnota se dopočítají přímo z definice pomocí qt():
xbar <- 0.492; s <- 0.015; n <- 20; mu0 <- 0.5
t <- (xbar - mu0) / s * sqrt(n)
t_krit <- qt(0.05, df = n - 1)
t
t_krit
[1] -2.385139
[1] -1.729133
Další dva příklady mají k dispozici surová data, takže je lze otestovat přímo t.test():
Životnost baterií. Výrobce udává průměrnou životnost 10 hodin, na 11 bateriích byly naměřeny hodnoty v hodinách.
x2 <- c(9.5, 10.5, 8.9, 9.2, 10.0, 8.5, 9.2, 8.8, 10.0, 9.5, 9.2)
t.test(x2, mu = 10, alternative = "two.sided")
    One Sample t-test

data:  x2
t = -3.42, df = 10, p-value = 0.006548
alternative hypothesis: true mean is not equal to 10
95 percent confidence interval:
 8.994081 9.787737
sample estimates:
mean of x
 9.390909
: skutečná životnost se od deklarovaných 10 hodin statisticky významně liší (baterie vydrží méně).
Odpad materiálu. Na deseti obráběných kusech byl naměřen odpad materiálu v procentech; testuje se rozdíl proti 4 % a zároveň normalita dat.
x3 <- c(4.1, 4.0, 3.8, 3.9, 3.8, 3.8, 3.5, 3.7, 4.0, 4.0)
t.test(x3, mu = 4, alternative = "two.sided")
shapiro.test(x3)
    One Sample t-test

data:  x3
t = -2.4922, df = 9, p-value = 0.0343
alternative hypothesis: true mean is not equal to 4
95 percent confidence interval:
 3.732925 3.987075
sample estimates:
mean of x
     3.86

    Shapiro-Wilk normality test

data:  x3
W = 0.93156, p-value = 0.4634
: průměrný odpad se od 4 % statisticky významně liší (výběrový průměr 3,86 %). Shapiro-Wilkův test dává , předpoklad normality pro t-test je v pořádku.
Párový t-test
Používá se, když jsou měření závislá — na stejných objektech se měří dvě hodnoty a vyhodnocují se jejich diference , kde . Z dvojic se určí a ; testuje se vztah mezi zvoleným číslem (obvykle 0) a . Testové kritérium
| Kritický obor | ||
|---|---|---|
dbar <- 0.4; sd_d <- 0.35; n <- 10
t <- (dbar - 0) / sd_d * sqrt(n)
t_krit <- qt(0.95, df = n - 1)
t
t_krit
[1] 3.614032
[1] 1.833113
Testy o dvou základních souborech
Uvažují se dva nezávislé základní soubory se znakem v a v . Z výběrů se určí a . Testují se varianty vztahů mezi , resp. mezi .
F-test o rozptylech
Statistika
má Fisherovo-Snedecorovo rozdělení o a stupních volnosti.
| Kritický obor | ||
|---|---|---|
| nebo | ||
Dvouvýběrový t-test o středních hodnotách
Volba statistiky závisí na tom, zda jsou rozptyly považovány za shodné:
se použije, pokud jsou rozptyly alespoň přibližně shodné; při rozdílných rozptylech
| Kritický obor | ||
|---|---|---|
Postup je dvoukrokový: nejprve F-test rozhodne o shodě rozptylů, pak se podle výsledku zvolí nebo .
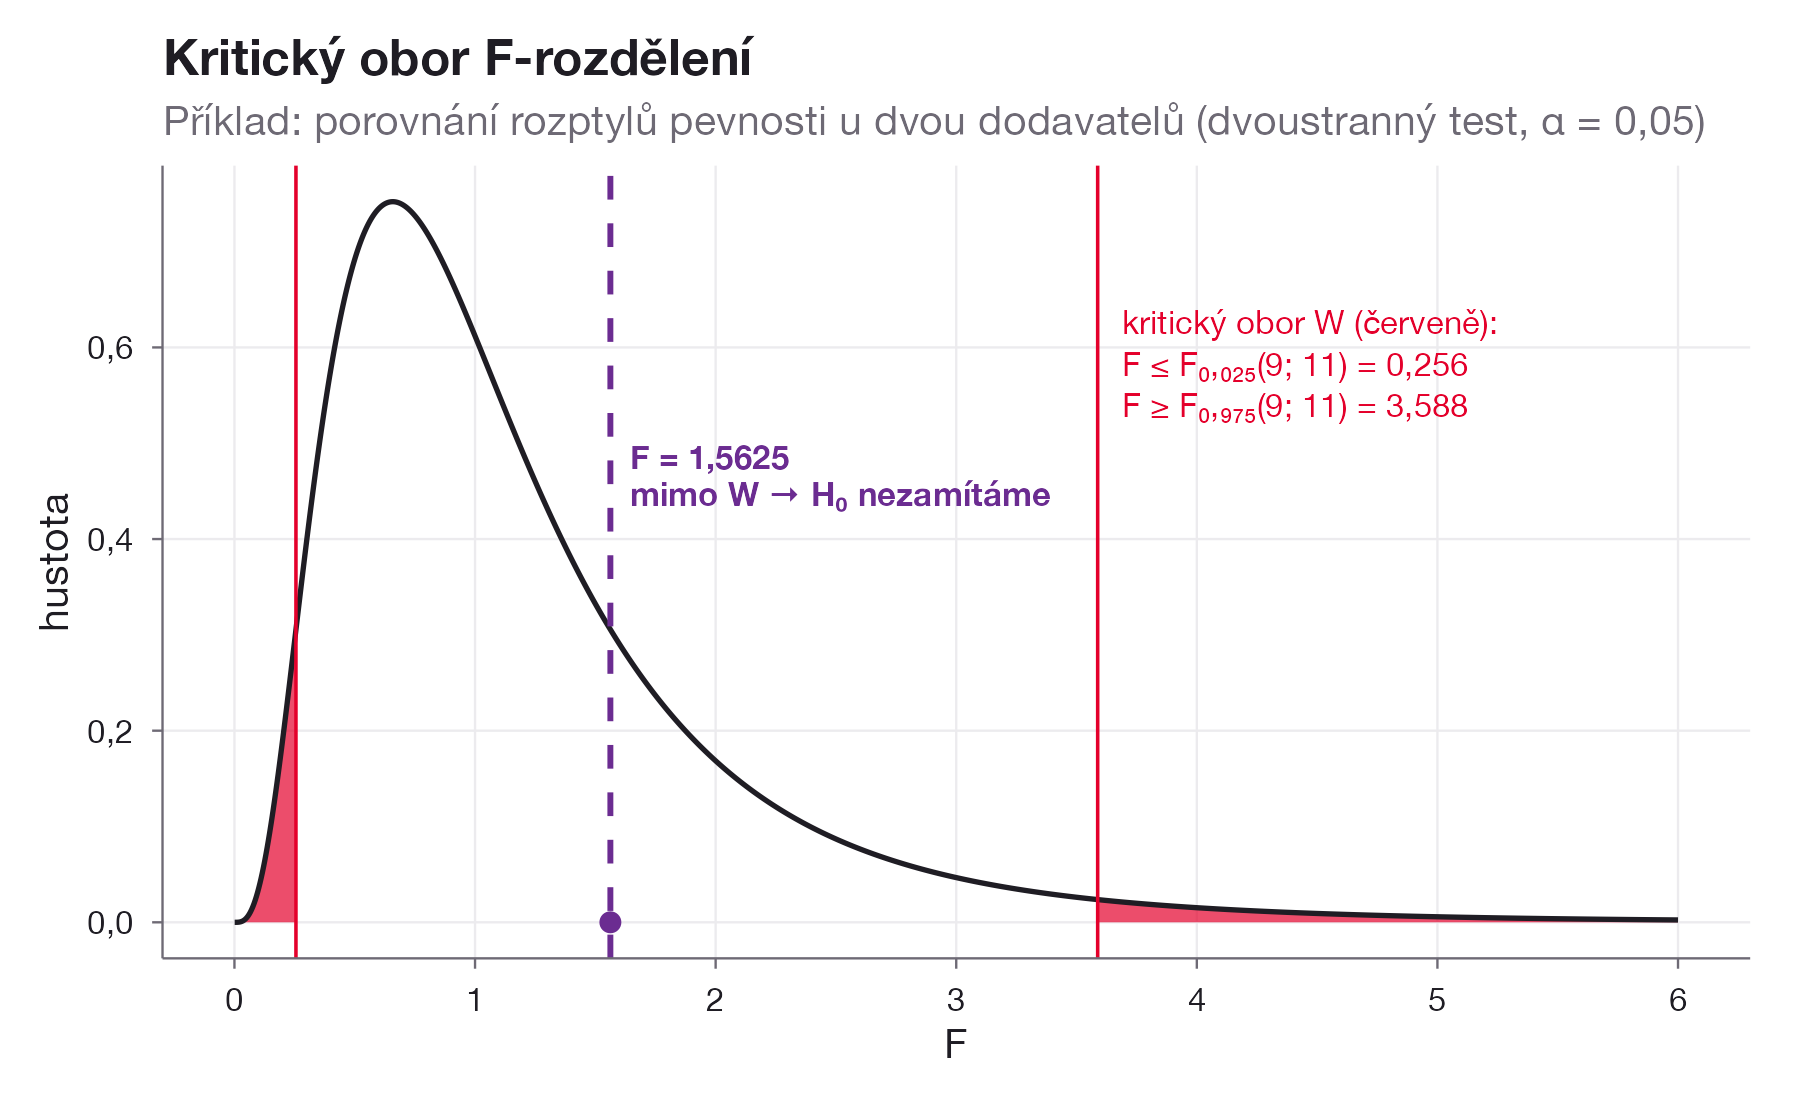
s1 <- 25; n1 <- 10
s2 <- 16; n2 <- 12
Fstat <- s1 / s2
F_dolni <- qf(0.025, n1 - 1, n2 - 1)
F_horni <- qf(0.975, n1 - 1, n2 - 1)
Fstat
F_dolni
F_horni
[1] 1.5625
[1] 0.2556189
[1] 3.587899
sp2 <- ((n1 - 1) * s1 + (n2 - 1) * s2) / (n1 + n2 - 2)
t <- (82 - 75) / sqrt(sp2) * sqrt(n1 * n2 / (n1 + n2))
t_krit <- qt(0.975, df = n1 + n2 - 2)
sp2
t
t_krit
[1] 20.05
[1] 3.65107
[1] 2.085963
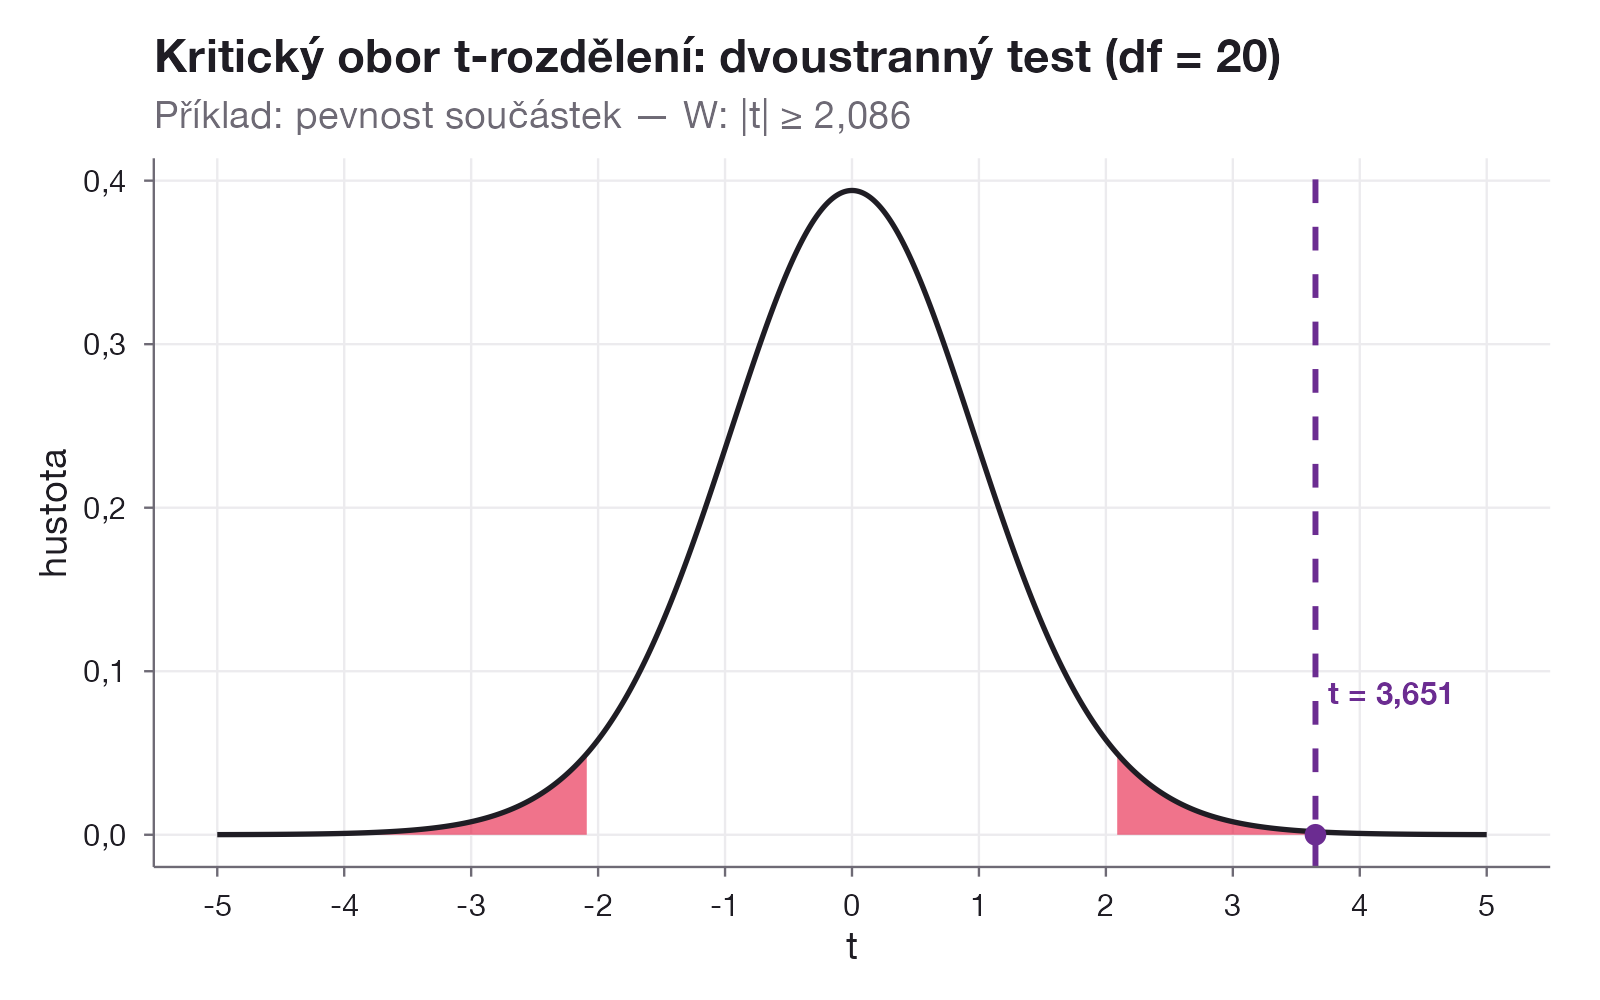
V R provede obě kroky var.test() a t.test(). Parametr var.equal nastavuje volbu mezi a : TRUE znamená předpoklad shodných rozptylů (podle výsledku F-testu), FALSE předpoklad rozdílných rozptylů.
Kabely A/B. Pevnost v tahu dvou výrobců (MPa, 12 kabelů od každého):
A <- c(313, 299, 315, 312, 310, 308, 314, 313, 305, 310, 309, 314)
B <- c(307, 322, 313, 313, 311, 316, 315, 314, 308, 319, 313, 312)
var.test(A, B)
t.test(A, B, var.equal = TRUE)
    F test to compare two variances

data:  A and B
F = 1.1905, num df = 11, denom df = 11, p-value = 0.7776
alternative hypothesis: true ratio of variances is not equal to 1
95 percent confidence interval:
 0.3427173 4.1354275
sample estimates:
ratio of variances
          1.190497

    Two Sample t-test

data:  A and B
t = -1.9096, df = 22, p-value = 0.06932
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -7.1273286  0.2939953
sample estimates:
mean of x mean of y
 310.1667  313.5833
F-test shodu rozptylů nezamítá (), proto var.equal = TRUE. Výsledný t-test dává — na hladině 5 % se nezamítá, ale hodnota je těsně nad hranicí.
Výšky chlapců a dívek v páté třídě:
boys <- c(130, 140, 136, 141, 139, 133, 149, 151, 139, 136, 138, 142, 127, 139, 147)
girls <- c(135, 141, 143, 132, 146, 146, 151, 141, 141, 131, 142, 141)
var.test(boys, girls)
t.test(boys, girls, var.equal = TRUE)
    F test to compare two variances

data:  boys and girls
F = 1.2721, num df = 14, denom df = 11, p-value = 0.6977
alternative hypothesis: true ratio of variances is not equal to 1
95 percent confidence interval:
 0.3787299 3.9365720
sample estimates:
ratio of variances
          1.272082

    Two Sample t-test

data:  boys and girls
t = -0.70344, df = 25, p-value = 0.4883
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -6.67727  3.27727
sample estimates:
mean of x mean of y
 139.1333  140.8333
F-test shodu rozptylů nezamítá (), t-test s var.equal = TRUE dává : na hladině 5 % se rozdíl průměrných výšek chlapců a dívek neprokázal.
Testy dobré shody a normalita
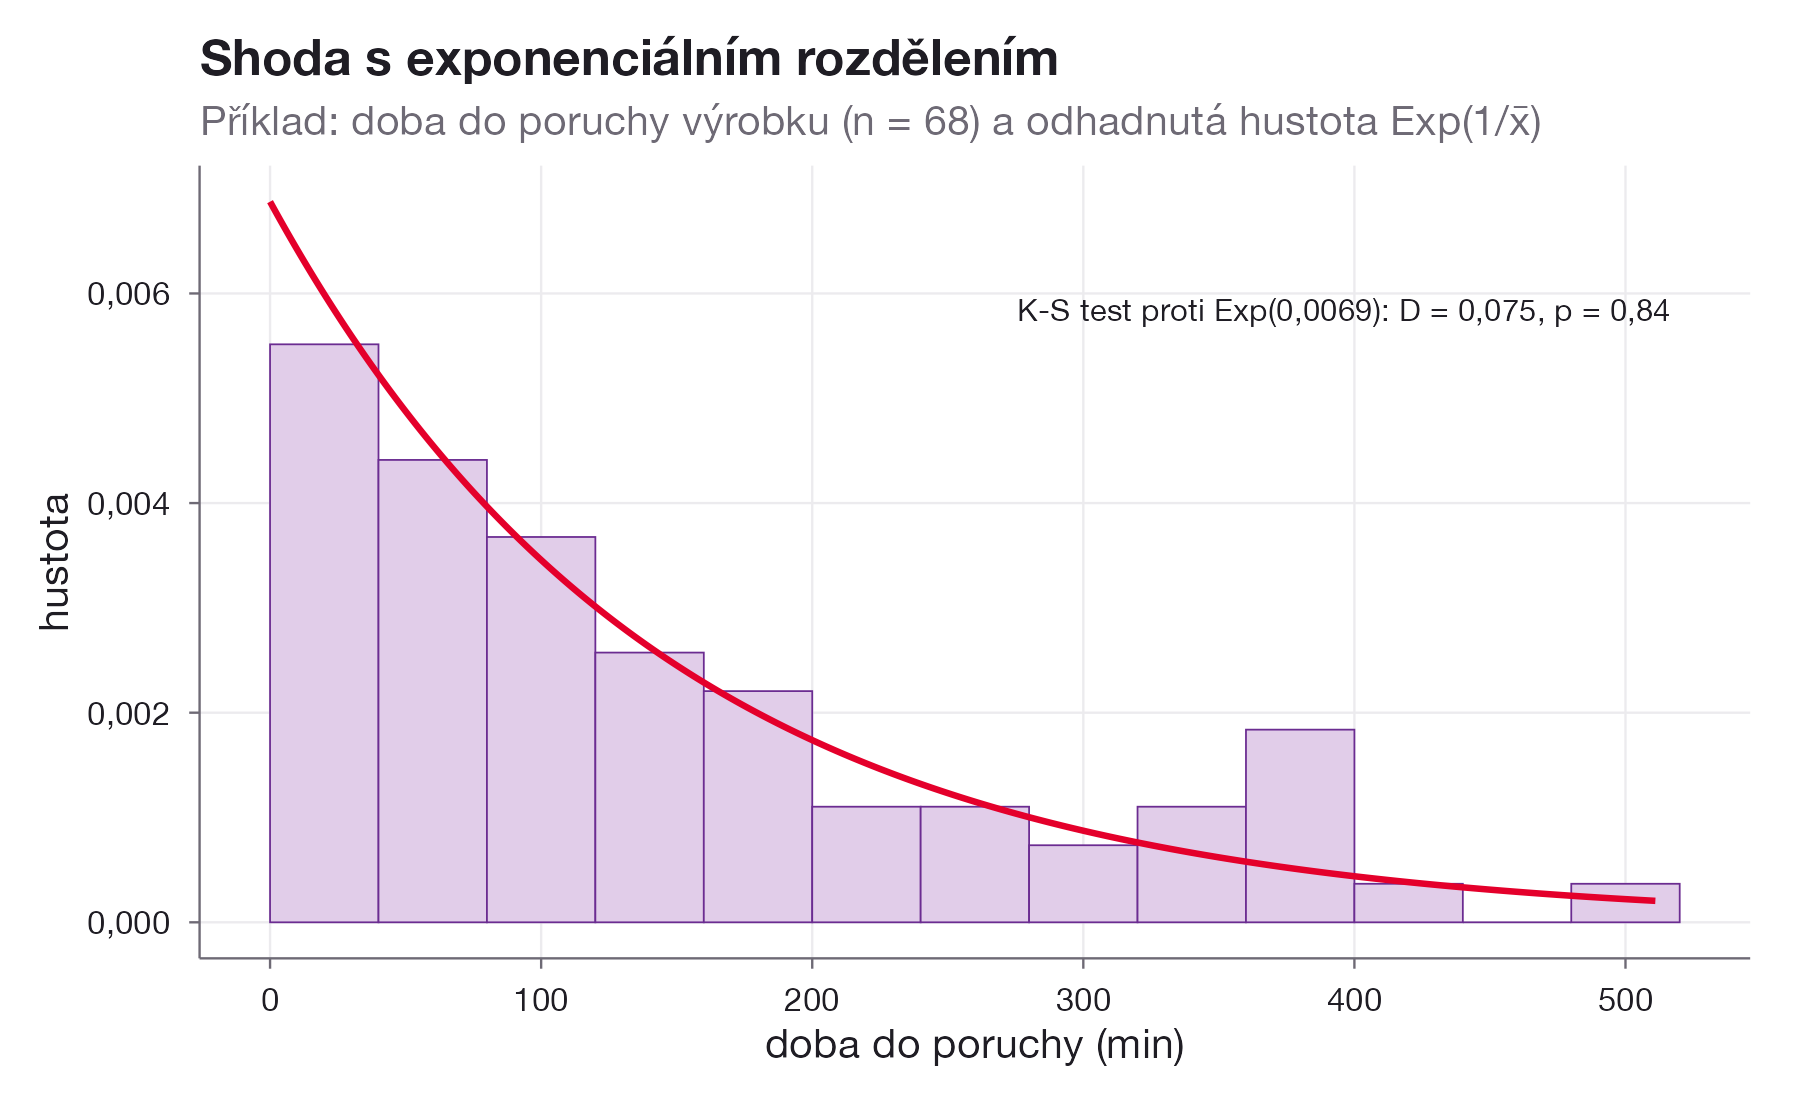
Testy dobré shody ověřují, zda datový soubor pochází ze základního souboru s určitým typem rozdělení (normální, exponenciální apod.).
Kolmogorovův-Smirnovův test
Univerzální test pro spojitá rozdělení. Porovnává empirickou distribuční funkci s teoretickou distribuční funkcí testovaného rozdělení.
- : odchylky mezi a jsou náhodné (data mají dané rozdělení).
- : data nemají dané rozdělení.
- Testové kritérium: .
- Kritický obor: ; pro se kritická hodnota aproximuje zlomkem .
V R test provádí ks.test(), kde se za F(x) dosadí příslušná distribuční funkce ("pnorm", "pexp", …) s jejími parametry:
x3 <- c(4.1, 4.0, 3.8, 3.9, 3.8, 3.8, 3.5, 3.7, 4.0, 4.0)
ks.test(x3, "pnorm", mean(x3), sd(x3))
    Asymptotic one-sample Kolmogorov-Smirnov test

data:  x3
D = 0.18469, p-value = 0.8847
alternative hypothesis: two-sided
: odpad materiálu je slučitelný s normálním rozdělením se stejným průměrem a směrodatnou odchylkou.
Shapiro-Wilkův test
Nejpoužívanější a nejsilnější obecný test normality, citlivý na odchylky v šikmosti i špičatosti. Využívá korelaci mezi uspořádanými hodnotami výběru a jejich očekávanými hodnotami v normálním rozdělení.
- : data mají normální rozdělení.
- : data nemají normální rozdělení.
- Testová statistika ; hodnoty blízké 1 indikují shodu s normalitou.
Na rozdíl od ostatních testů v této kapitole se Shapiro-Wilkův test v praxi vyhodnocuje pouze přes p-hodnotu (tabulka kritických hodnot pro se běžně neudává): nezamítáme (normalitu lze předpokládat); zamítáme (předpoklad normality je porušen).
x2 <- c(9.5, 10.5, 8.9, 9.2, 10.0, 8.5, 9.2, 8.8, 10.0, 9.5, 9.2)
shapiro.test(x2)
    Shapiro-Wilk normality test

data:  x2
W = 0.96022, p-value = 0.7744
U dat o životnosti baterií se normalita nezamítá (), předpoklad t-testu je tedy splněn.
Neparametrické testy
Když předpoklad normality neplatí, nahrazují t-testy jejich neparametrické obdoby — Wilcoxonovy testy posuzují medián () místo střední hodnoty a nevyžadují normalitu dat.
Wilcoxonovy testy
| Příkaz v R | ||
|---|---|---|
wilcox.test(x, alternative = "greater", mu = c) | ||
wilcox.test(x, alternative = "two.sided", mu = c) | ||
wilcox.test(x, alternative = "less", mu = c) |
Jednovýběrový Wilcoxonův test (obdoba t-testu) posuzuje odchylku mediánu od konstanty .
Jednovýběrový Wilcoxonův test na diferencích (obdoba párového t-testu) posuzuje odchylku mediánu rozdílu od ; v R se volá se stejnými argumenty jako výše a navíc paired = TRUE.
Dvouvýběrový Wilcoxonův test (obdoba dvouvýběrového t-testu) posuzuje odchylku mediánů dvou nezávislých výběrů; argument mu odpadá. Pro výšky chlapců a dívek z příkladu výše:
boys <- c(130, 140, 136, 141, 139, 133, 149, 151, 139, 136, 138, 142, 127, 139, 147)
girls <- c(135, 141, 143, 132, 146, 146, 151, 141, 141, 131, 142, 141)
wilcox.test(boys, girls, alternative = "two.sided")
    Wilcoxon rank sum exact test

data:  boys and girls
W = 69, p-value = 0.315
alternative hypothesis: true location shift is not equal to 0
: mediány výšek chlapců a dívek se statisticky významně neliší — stejný závěr jako u dvouvýběrového t-testu.
Kruskalův-Wallisův test
Zobecnění dvouvýběrového Wilcoxonova testu, neparametrická obdoba analýzy rozptylu jednoduchého třídění. : všechny výběry pocházejí ze stejného rozdělení.
kruskal.test(kvantitativní_proměnná ~ faktor, data = soubor)
Mediánový test
Má stejný účel jako Kruskalův-Wallisův test (obdoba analýzy rozptylu jednoduchého třídění, : všechny výběry pocházejí ze stejného rozdělení) a je součástí balíčku agricolae:
library(agricolae)
Median.test(kvantitativní_proměnná, faktor)
Friedmanův test
Neparametrická obdoba analýzy rozptylu dvojného třídění s jedním pozorováním v každé podtřídě. : distribuční funkce veličin jsou totožné.
friedman.test(kvantitativní_proměnná ~ faktor_A | faktor_B, data = soubor)
# jsou-li proměnné samostatné vektory (bez argumentu data):
friedman.test(kvantitativní_proměnná, faktor_A, faktor_B)
Přehled testů
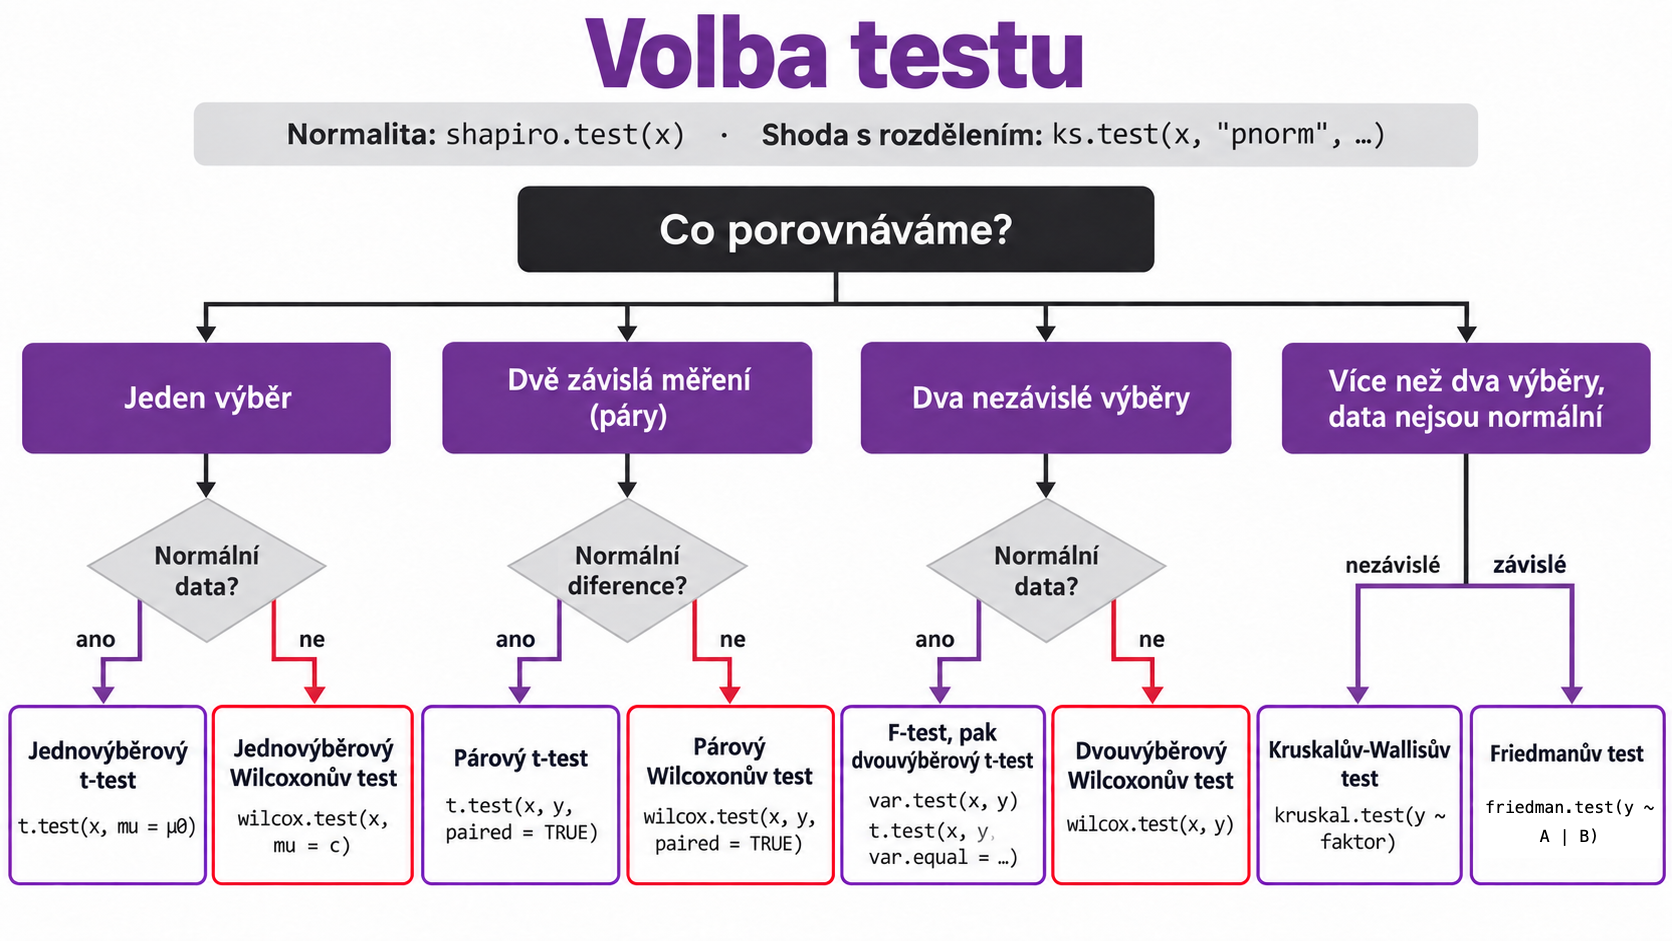
| Situace | Test | R funkce |
|---|---|---|
| Jedna střední hodnota vs. zadané číslo, normální data | jednovýběrový t-test | t.test(x, mu = ..., alternative = ...) |
| Rozdíl dvou závislých měření, diference normální | párový t-test | t.test(x, y, paired = TRUE) |
| Shoda rozptylů dvou nezávislých normálních výběrů | F-test | var.test(x, y) |
| Shoda středních hodnot dvou nezávislých normálních výběrů | dvouvýběrový t-test | t.test(x, y, var.equal = TRUE/FALSE) |
| Shoda dat se zadaným typem rozdělení (normální, exponenciální, …) | Kolmogorovův-Smirnovův test | ks.test(x, "pnorm", mu, sigma), ks.test(x, "pexp", 1/delta) |
| Normalita dat | Shapiro-Wilkův test | shapiro.test(x) |
| Medián jednoho výběru vs. konstanta, data nejsou normální | jednovýběrový Wilcoxonův test | wilcox.test(x, mu = c, alternative = ...) |
| Medián diferencí dvou závislých měření, data nejsou normální | párový Wilcoxonův test | wilcox.test(x, y, paired = TRUE, mu = c) |
| Mediány dvou nezávislých výběrů, data nejsou normální | dvouvýběrový Wilcoxonův test | wilcox.test(x, y) |
| Více než dva nezávislé výběry, data nejsou normální | Kruskalův-Wallisův test | kruskal.test(y ~ faktor, data) |
| Více než dva nezávislé výběry, data nejsou normální (alternativa) | mediánový test | Median.test(y, faktor) z balíčku agricolae |
| Více než dva závislé výběry (dvojné třídění, jedno pozorování na podtřídu) | Friedmanův test | friedman.test(y ~ A | B, data) |
Časté chyby
- Nezamítnutí není důkaz, že platí. U kabelů A/B vyšlo — na hladině 5 % se nezamítá, ale hodnota je blízko hranice; správná interpretace je „data rovnost průměrů nevyvracejí“, ne „rovnost je prokázána“.
- Před párovým nebo dvouvýběrovým t-testem ověřte normalitu. U realitních odhadců vycházel párový t-test bez varování, ale Shapiro-Wilkův test na diferencích normalitu zamítl — správným testem byl párový Wilcoxonův test.
var.equalvt.test()se volí podle F-testu, ne podle výchozí hodnoty. Výchozí nastavení R jevar.equal = FALSE(Welchova varianta); pokud F-test potvrdí shodné rozptyly, je třeba explicitně napsatvar.equal = TRUE, jinak se použije jiná statistika a jiné stupně volnosti.- Jednostranná vs. dvoustranná alternativa mění kritický obor i závěr. Volba
alternative = "greater"/"less"/"two.sided"musí odpovídat formulaci v zadání, ne být ponechána na výchozí hodnotě"two.sided". - Shapiro-Wilkův test se vyhodnocuje jen přes p-hodnotu, ne porovnáním s tabulkovou kritickou hodnotou jako u ostatních testů v této kapitole.
Související stránky
- Metody aplikované statistiky
- Náhodné veličiny a rozdělení pravděpodobnosti
- Popisná statistika a datové soubory
- Regresní a korelační analýza
- Kontingenční tabulky
- Regulační diagramy a indexy způsobilosti
- Tahák pro R
Reference
KROPÁČ, J. Statistika A. 4. vyd. Brno: Fakulta podnikatelská VUT, 2011.