
Náhodné veličiny a rozdělení pravděpodobnosti
Náhodné veličiny a rozdělení pravděpodobnosti
Náhodná veličina
Metody aplikované statistiky pracuje s veličinami, jejichž hodnota závisí na náhodě. Formálně: uvažujeme základní prostor přiřazený výsledkům pokusu. Náhodná veličina je funkce, která prvkům přiřazuje reálná čísla , kde . Náhodné veličiny značíme velkými písmeny (, , ), jejich konkrétní hodnoty odpovídajícími malými písmeny (, , ); pravděpodobnost, že nabyla hodnoty , zapisujeme .
Podle typu hodnot, kterých náhodná veličina nabývá, rozlišujeme dva typy:
- Diskrétní náhodná veličina — prvky se zobrazí na osu reálných čísel jako izolované body , přičemž každý z nich má nenulovou pravděpodobnost. Příklad: počet bodů při hodu kostkou, počet studentů na cvičení.
- Spojitá náhodná veličina — hodnoty tvoří interval na ose reálných čísel, přičemž každý bod intervalu má nulovou pravděpodobnost. Příklad: velikost výrobku, doba psaní testu, výška dětí v populaci.
Distribuční funkce
Náhodná veličina nabývá při pokusu určité hodnoty, aniž bychom předem věděli, které. Při opakování pokusu se ale projevují zákonitosti, které popisují zákony rozdělení. Nejobecnějším z nich je distribuční funkce.
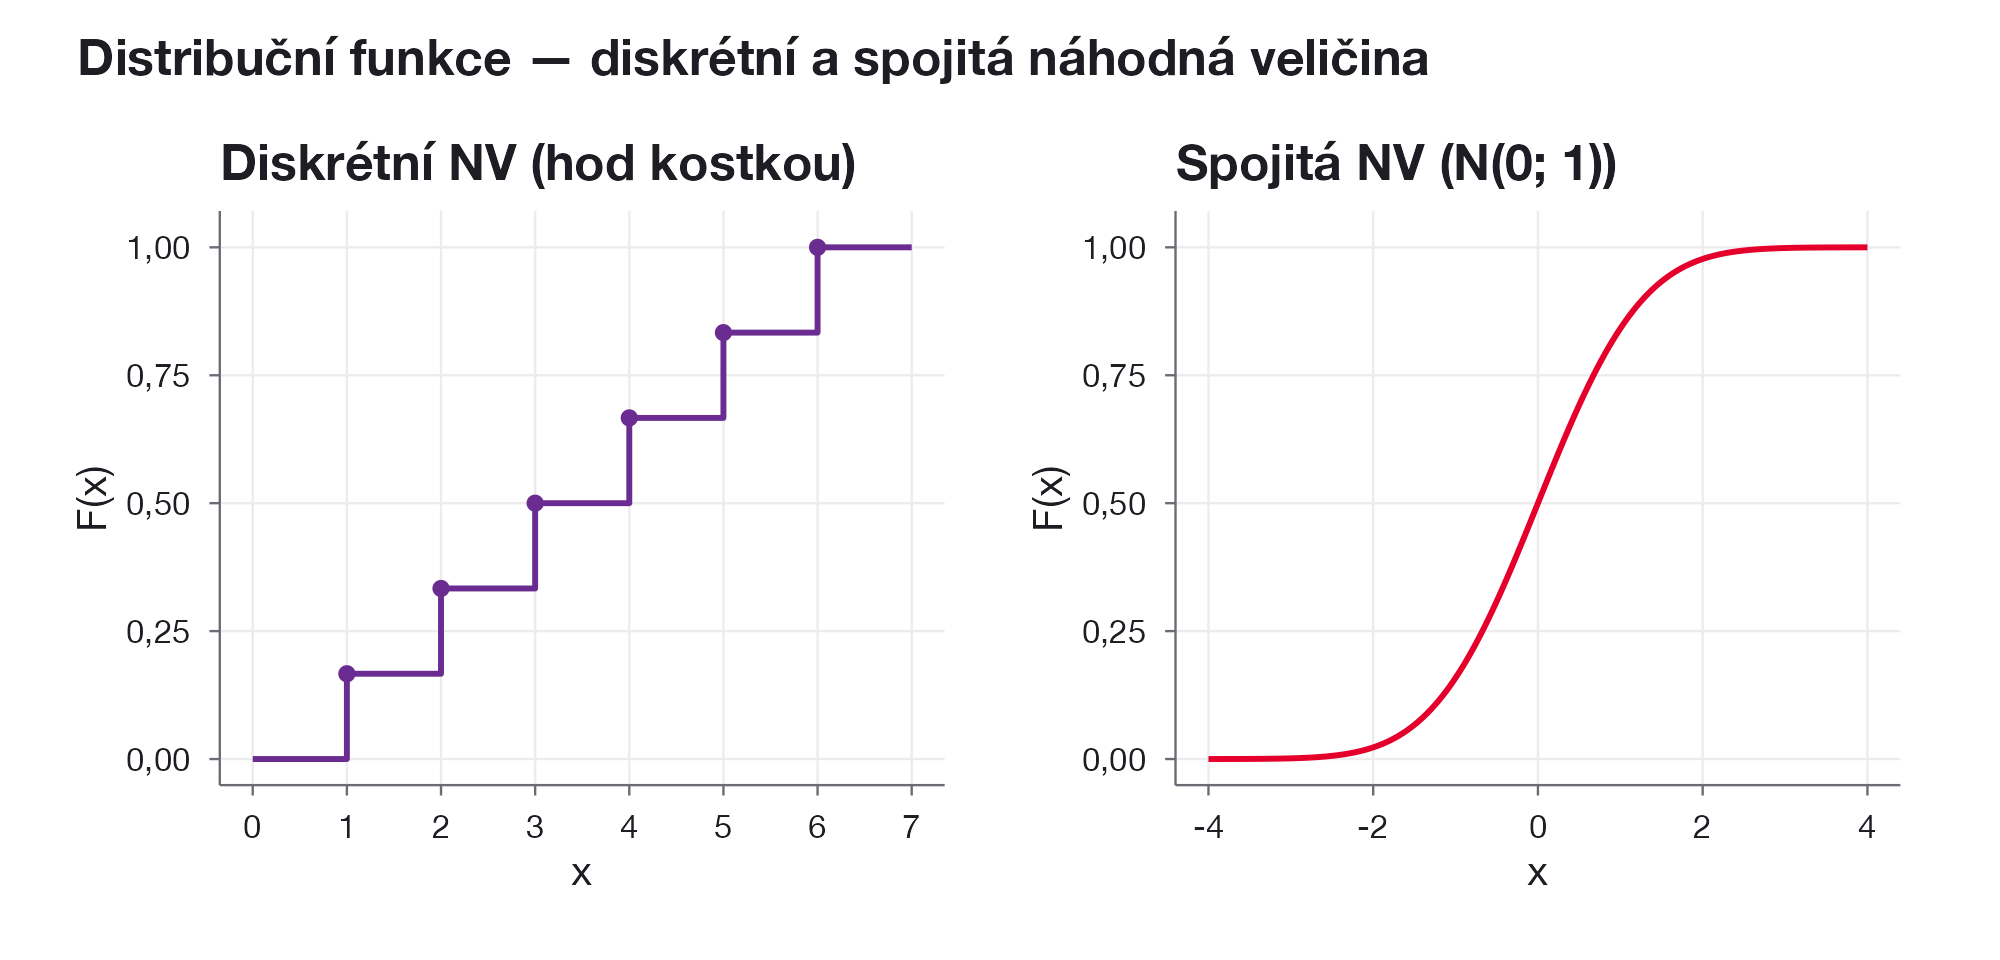
Značí-li například výšku mužů v populaci, pak je pravděpodobnost, že muž měří nejvýše 175 cm.
Pro distribuční funkci vždy platí:
- ,
- je neklesající: ,
- je spojitá zprava: ,
- , .
U spojité náhodné veličiny je distribuční funkce svázaná s hustotou pravděpodobnosti vztahem
Pravděpodobnost, že padne mezi body a , se pak počítá jako
Hustota pravděpodobnosti
Intuitivně: rozdělíme-li hodnoty náhodné veličiny (např. výšku mužů v populaci) do stejně širokých intervalů, bude v intervalech blízko průměru nahuštěno víc pozorování než v krajních intervalech — hustota tam bude vyšší.
Charakteristiky spojité náhodné veličiny
Střední hodnota je nejdůležitější charakteristika náhodné veličiny:
Je to číslo, kolem něhož kolísají výběrové průměry vypočtené ze sérií pozorovaných hodnot náhodné veličiny.
Rozptyl a směrodatná odchylka:
Směrodatná odchylka udává, jak moc jsou hodnoty náhodné veličiny rozptýlené kolem střední hodnoty. (Pro odhad těchto charakteristik z naměřených dat viz empirické protějšky v popisna-statistika.)
Kvantily udávají, jak jsou hodnoty náhodné veličiny rozděleny na ose reálných čísel v určitém pravděpodobnostním poměru. 100p%-ní kvantil je číslo, pro které při zvolené pravděpodobnosti platí
V intervalu leží 100p % hodnot, v intervalu leží 100(1-p) % hodnot. Nejdůležitější kvantily jsou medián , dolní kvartil a horní kvartil .
Normální rozdělení
Spojitá náhodná veličina má normální rozdělení , jestliže její hustota pravděpodobnosti a distribuční funkce jsou dány předpisy
přičemž , .
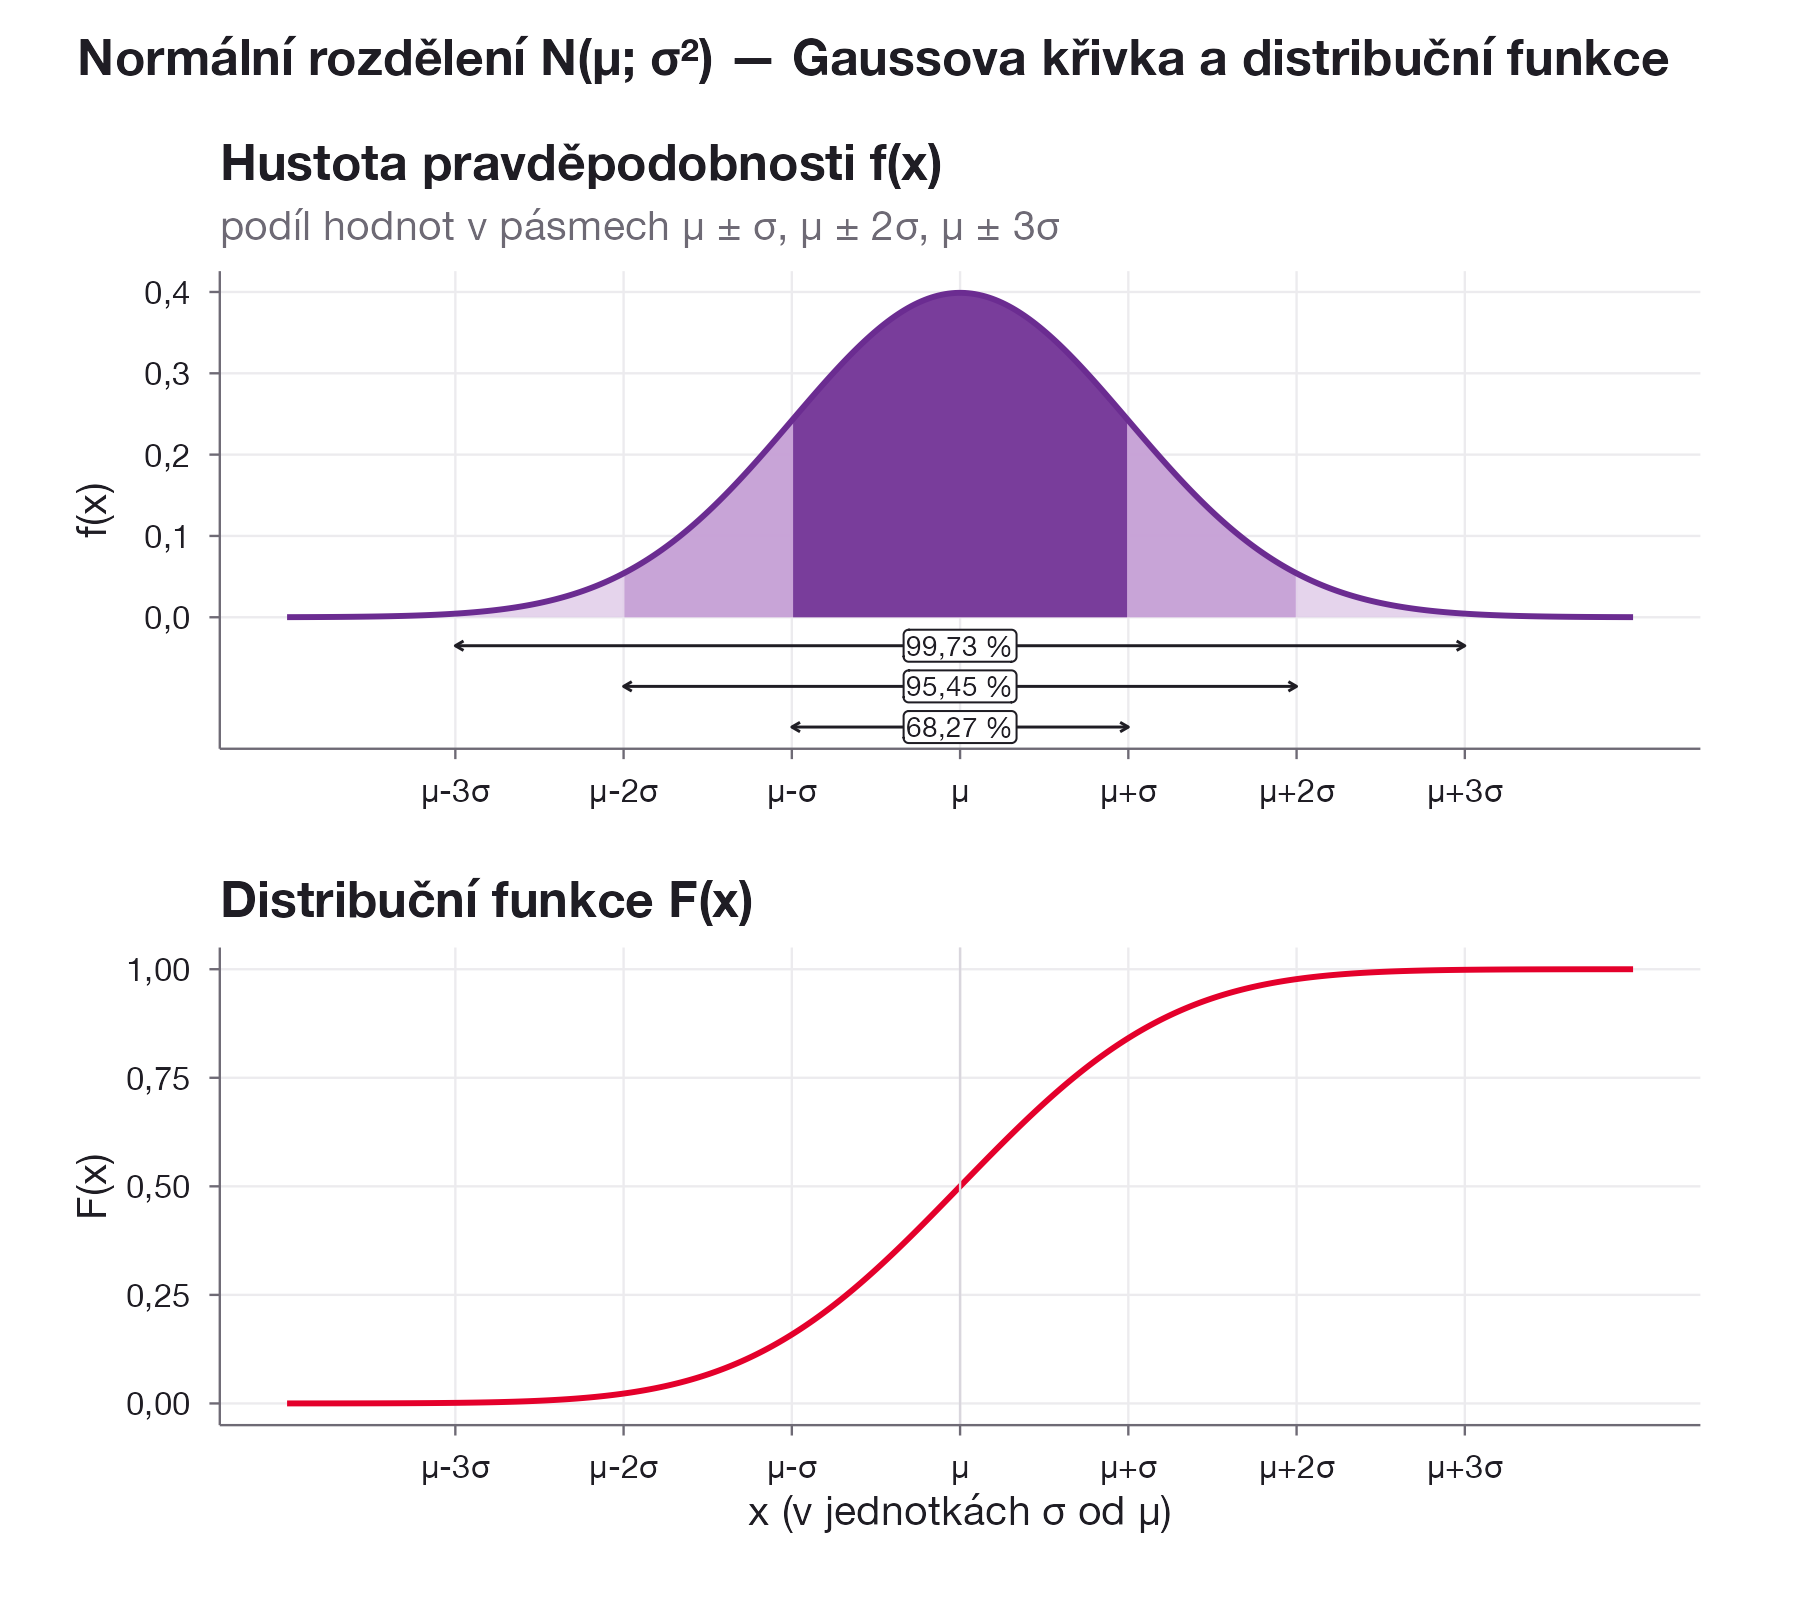
Křivka hustoty se nazývá Gaussova křivka: je symetrická kolem svislé přímky procházející , kde má globální maximum, a ve vzdálenosti od se téměř dotýká osy x — zhruba 99,73 % hodnot leží v intervalu .
Zvláštní postavení má normované normální rozdělení , na které se dá libovolné normální rozdělení převést standardizací .
Hustota normálního rozdělení f(x) = 1/(σ√(2π)) krát exp(−(x−μ)²/(2σ²)) s nastavitelnou střední hodnotou μ a směrodatnou odchylkou σ. Se zvyšujícím se σ se křivka zplošťuje a rozšiřuje, se změnou μ se posouvá po ose x.
V R:
dnorm(0)
pnorm(1.96)
qnorm(0.975)
[1] 0.3989423
[1] 0.9750021
[1] 1.959964
dnorm(0) je hodnota hustoty v bodě 0, pnorm(1.96) je a qnorm(0.975) je 97,5%-ní kvantil — hodnota, pod kterou leží 97,5 % pravděpodobnosti.
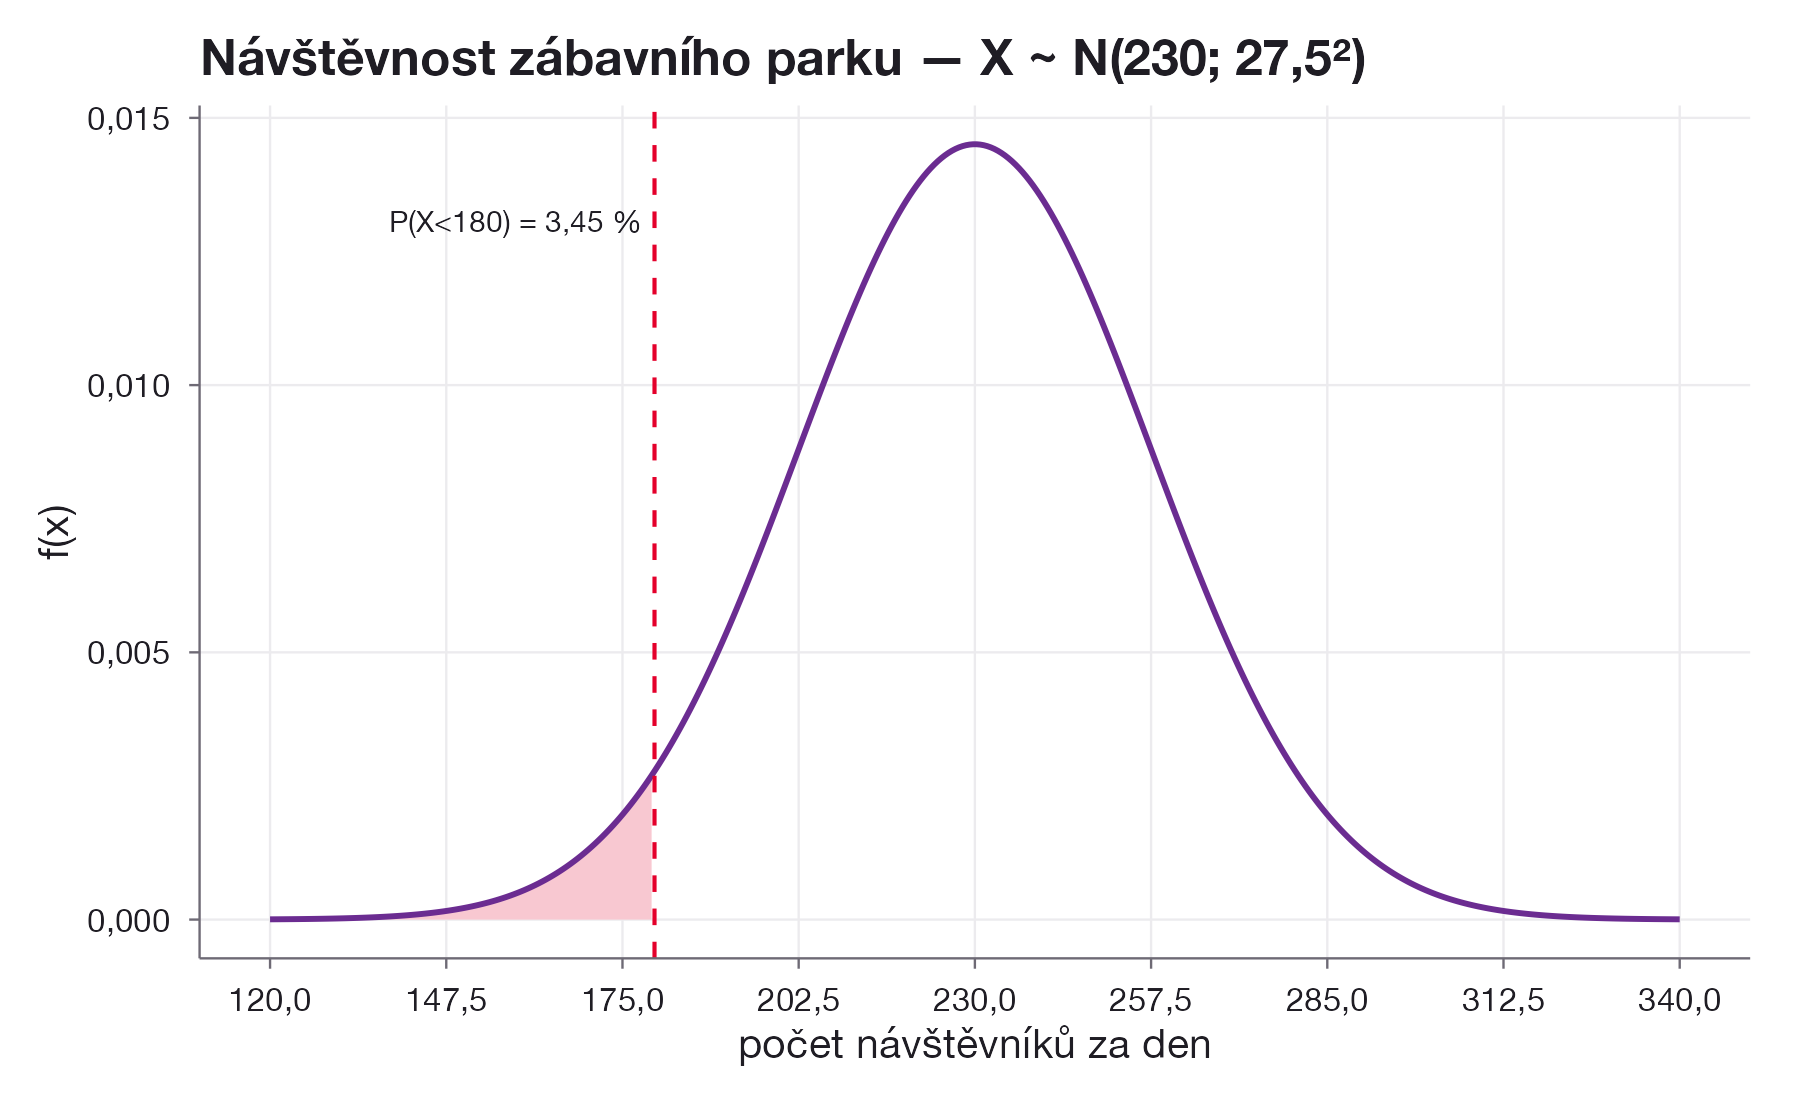
pnorm(180, mean = 230, sd = 27.5)
[1] 0.03451817
Park je ztrátový přibližně v 3,45 % dní.
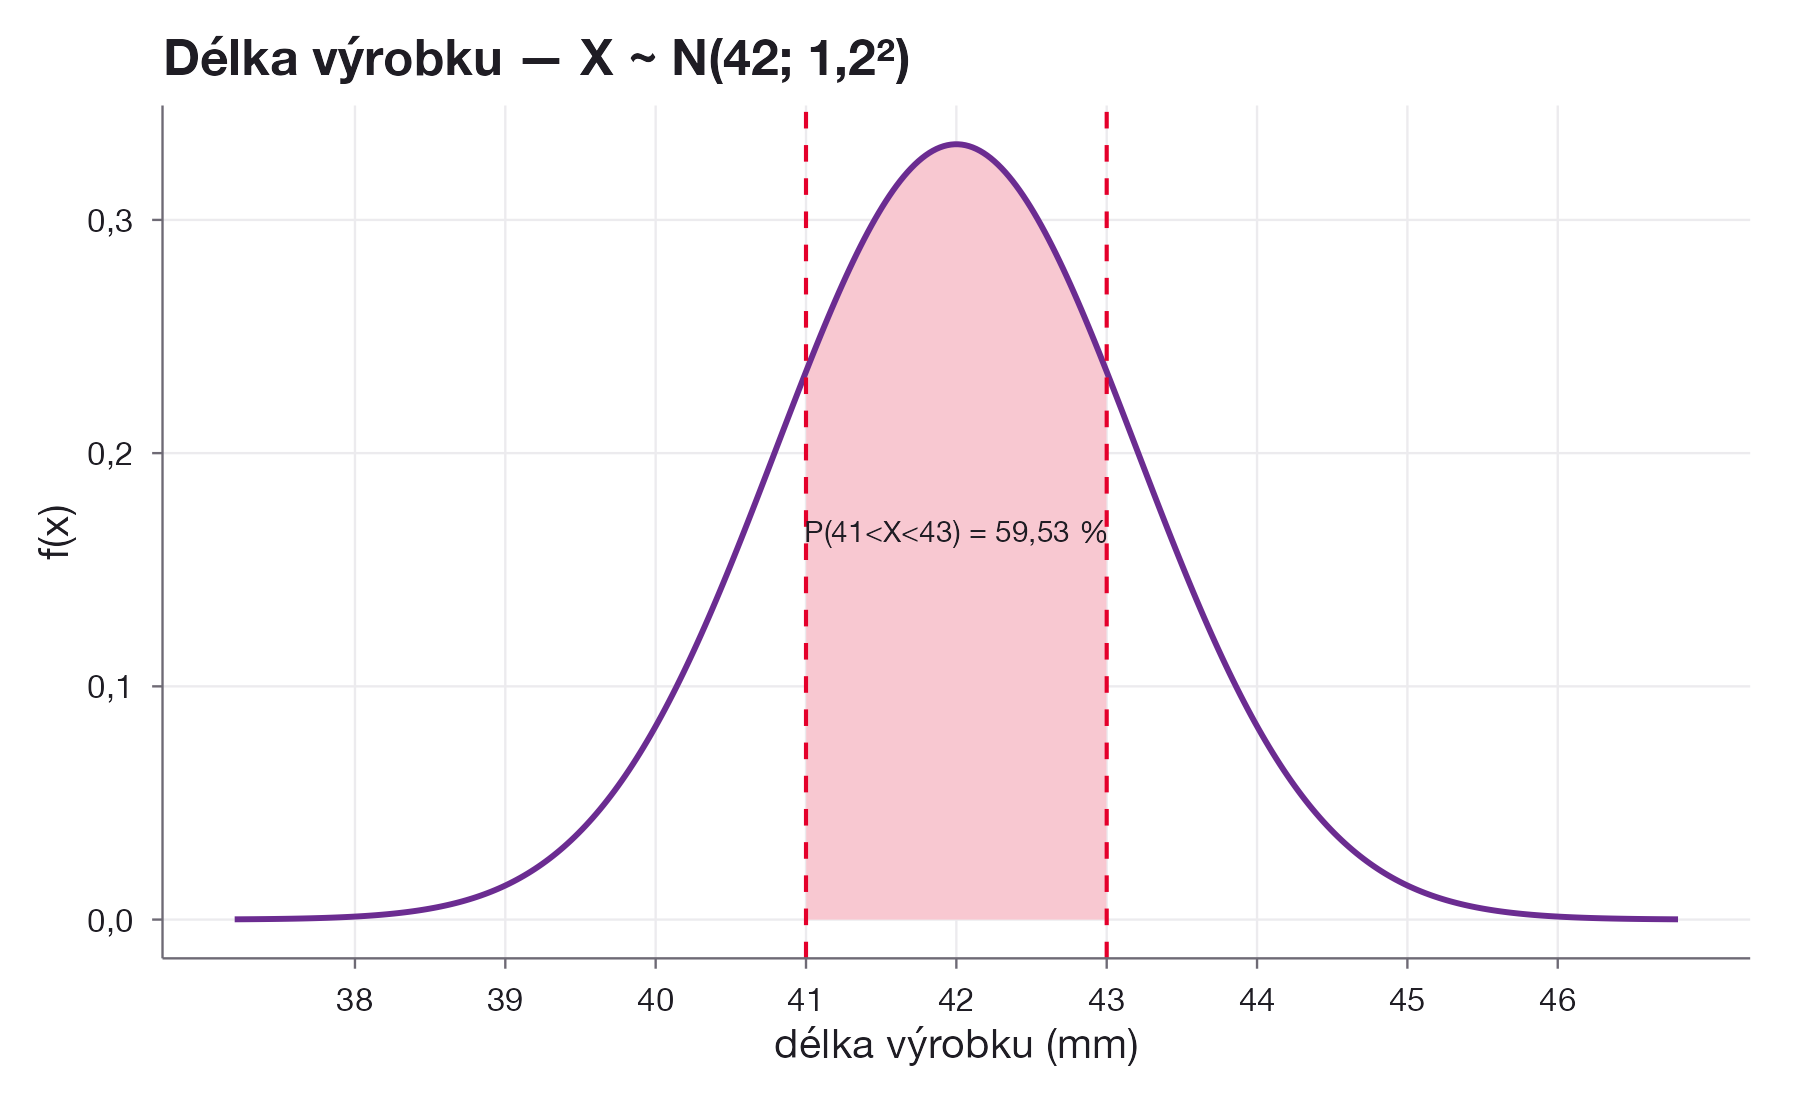
pnorm(43, mean = 42, sd = 1.2) - pnorm(41, mean = 42, sd = 1.2)
[1] 0.5953432
Do 1. jakostní třídy spadá přibližně 59,53 % výrobků.
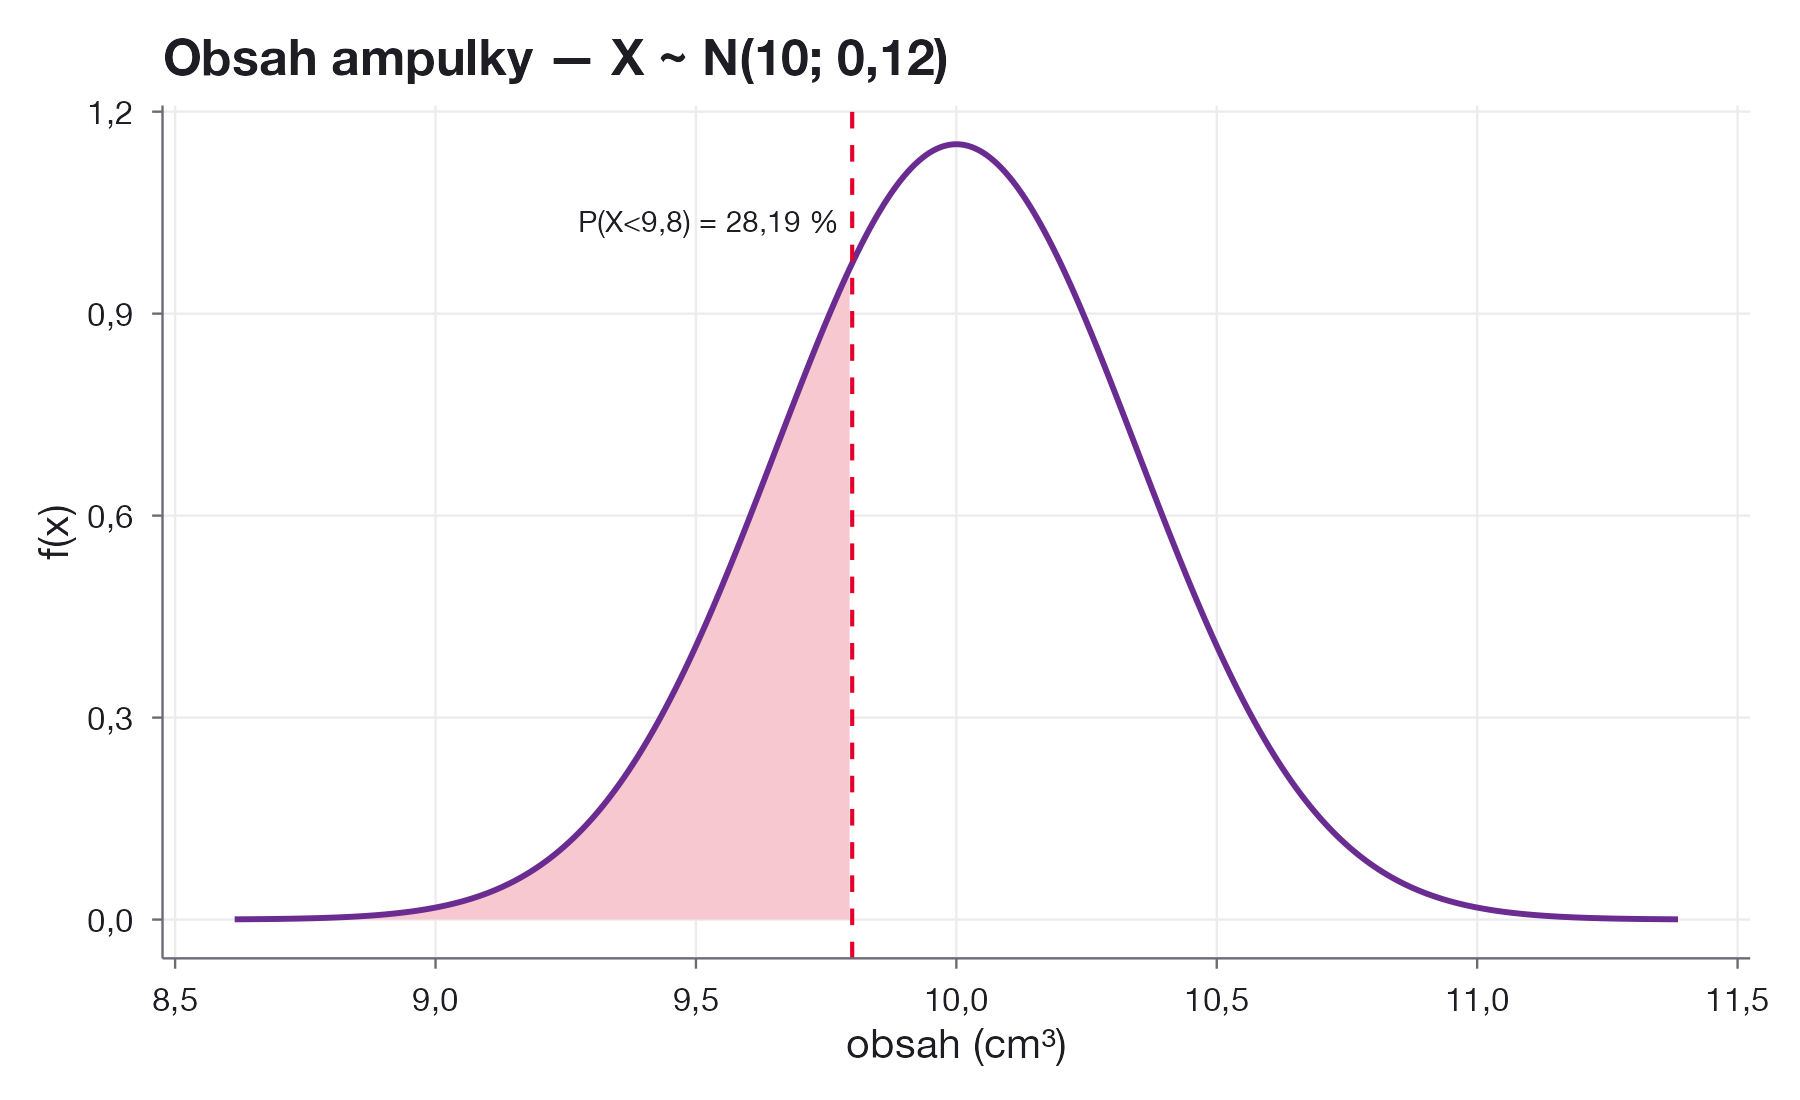
pnorm(9.8, mean = 10, sd = sqrt(0.12))
[1] 0.2818514
Obsah menší než 9,8 cm³ má přibližně 28,19 % ampulek.
Další rozdělení dostupná v R
Vedle normálního rozdělení R přímo nabízí hustotu, distribuční funkci a kvantilovou funkci i pro další běžná rozdělení. Pojmenování funkcí je jednotné: d* je hustota/pravděpodobnostní funkce, p* distribuční funkce (s lower.tail = FALSE, případně čtvrtým argumentem TRUE/FALSE, pro horní chvost) a q* kvantilová funkce.
| Rozdělení | / | horní chvost | |
|---|---|---|---|
| Binomické | dbinom(k, n, p) | pbinom(k, n, p) | pbinom(k, n, p, FALSE) |
| Poissonovo | dpois(k, lambda) | ppois(k, lambda) | ppois(k, lambda, FALSE) |
| Geometrické | dgeom(k, p) | pgeom(k, p) | pgeom(k, p, FALSE) |
| Hypergeometrické | dhyper(k, M, N-M, n) | phyper(k, M, N-M, n) | phyper(k, M, N-M, n, FALSE) |
| Exponenciální | dexp(k, 1/delta) | pexp(k, 1/delta) | pexp(k, 1/delta, FALSE) |
V R (pravděpodobnostní a distribuční funkce diskrétní náhodné veličiny , a pravděpodobnost, že u exponenciálního rozdělení se střední hodnotou nastane událost do 3 jednotek času):
x <- 0:5
round(dbinom(x, 5, 0.95), 4)
round(pbinom(x, 5, 0.95), 4)

delta <- 5
round(pexp(3, rate = 1 / delta), 4)
[1] 0.0000 0.0000 0.0011 0.0214 0.2036 0.7738
[1] 0.0000 0.0000 0.0012 0.0226 0.2262 1.0000
[1] 0.4512
Studentovo, Pearsonovo a Fisherovo-Snedecorovo rozdělení
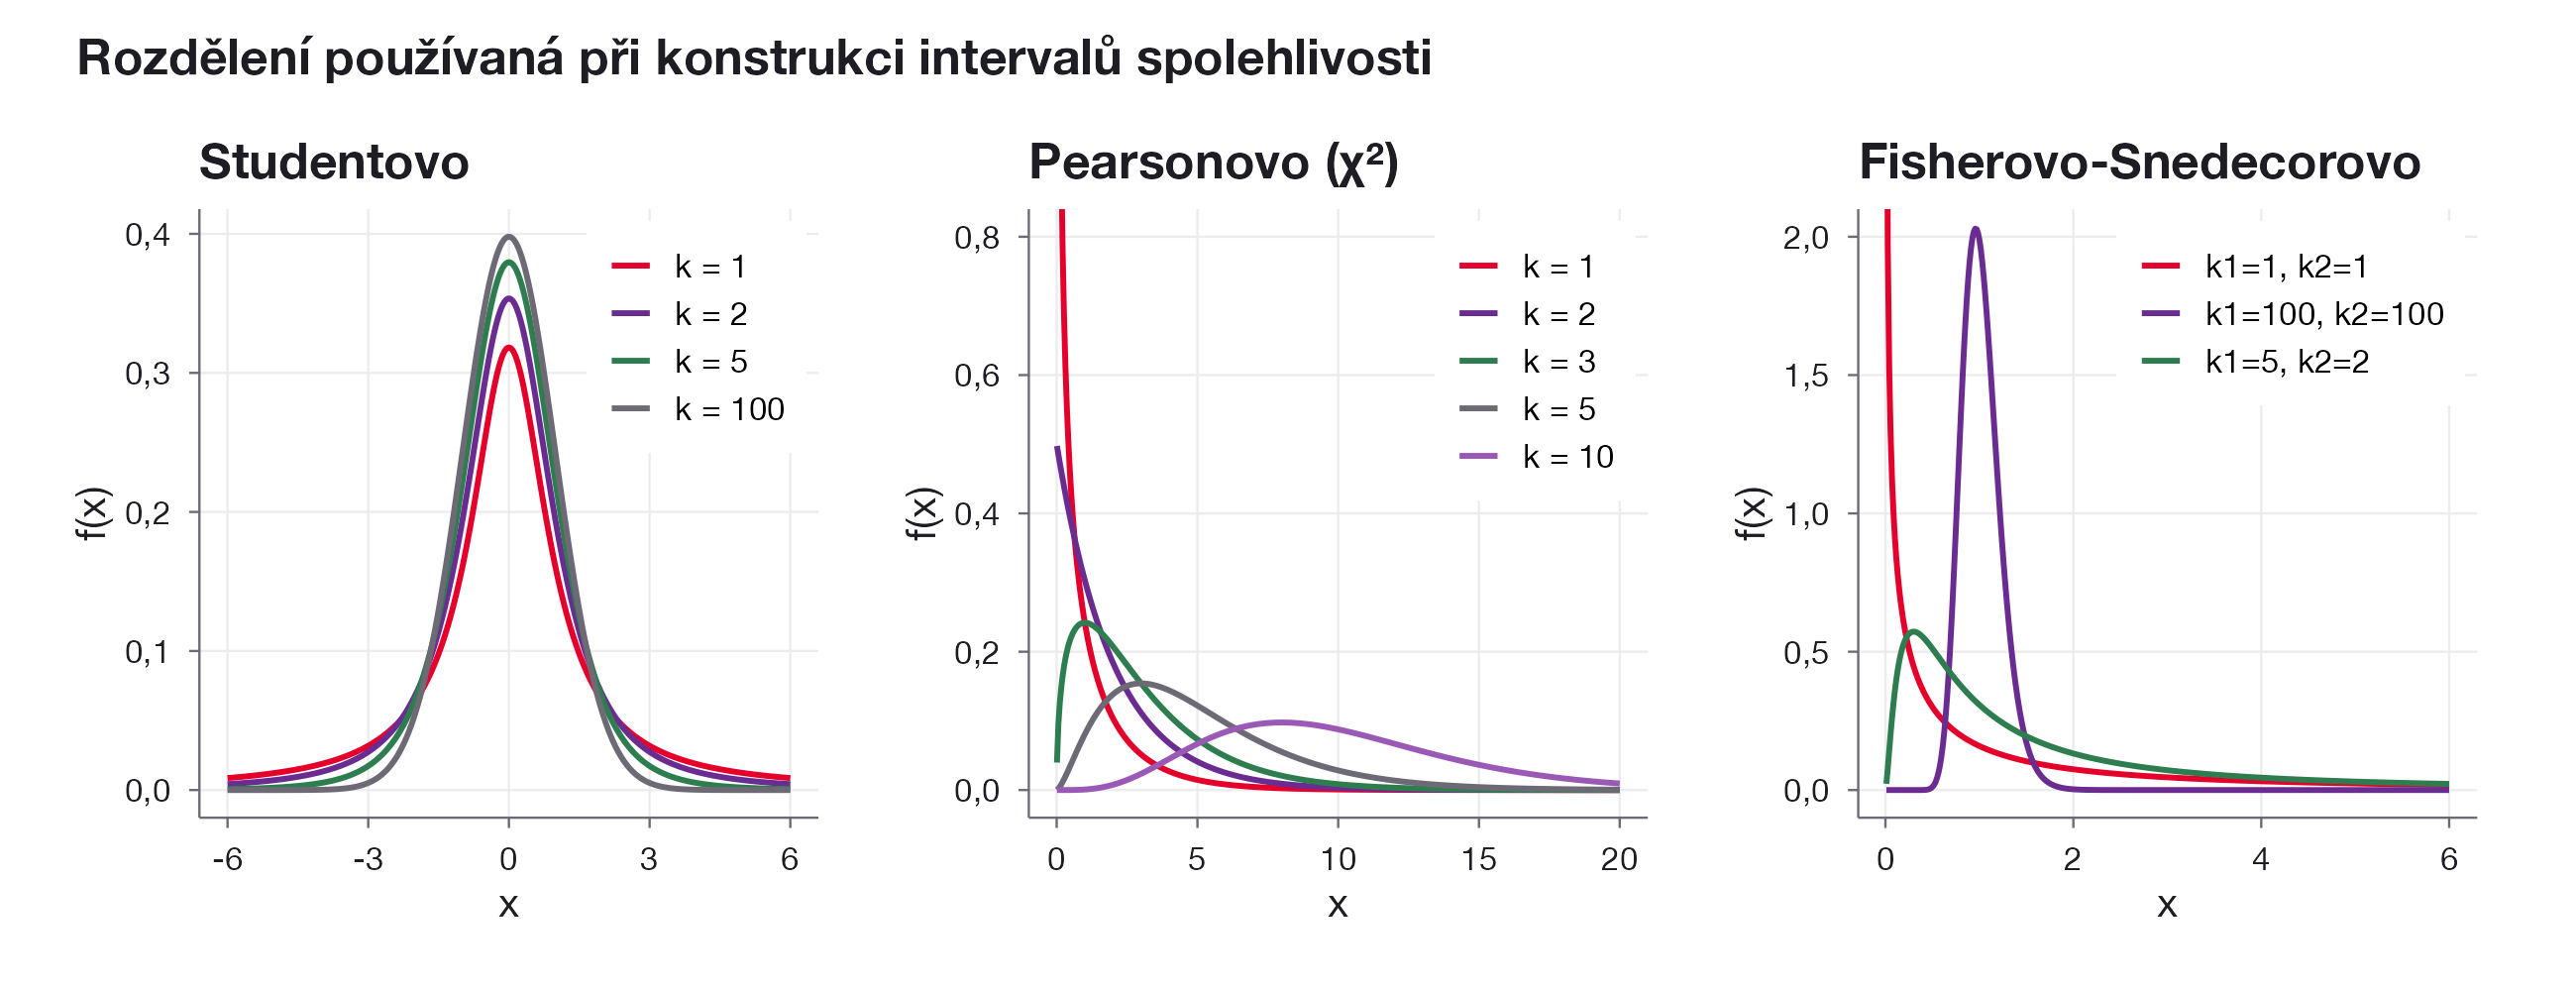
Tato tři rozdělení mají statistiky, které se dále používají při konstrukci intervalů spolehlivosti a testování hypotéz (viz testovani-hypotez) — na rozdíl od normálního rozdělení se v příkladech této kapitoly samostatně nepočítají, jsou to nástroje pro další kapitoly.
Studentovo rozdělení s stupni volnosti má hustotu pravděpodobnosti
kde je funkce beta. Je symetrické kolem nuly; číslo určuje tvar křivky — s rostoucím se rozdělení blíží normálnímu.
Pearsonovo (chí-kvadrát) rozdělení s stupni volnosti:
kde je funkce gama.
Fisherovo-Snedecorovo rozdělení se stupni volnosti a :
Srovnání hustoty standardizovaného normálního rozdělení N(0;1) s hustotou Studentova rozdělení pro k = 1, 2 a 4 stupně volnosti. S rostoucím k se Studentovo rozdělení přibližuje normálnímu — má méně těžké konce a vyšší vrchol.
R funkce pro tato tři rozdělení:
| Rozdělení | hustota | distribuční funkce | kvantil |
|---|---|---|---|
| Studentovo | dt(x, df = k) | pt(x, df = k) | qt(p, df = k) |
| Pearsonovo | dchisq(x, df = k) | pchisq(x, df = k) | qchisq(p, df = k) |
| Fisherovo-Snedecorovo | df(x, df1 = k1, df2 = k2) | pf(x, df1 = k1, df2 = k2) | qf(p, df1 = k1, df2 = k2) |
V R (97,5%-ní kvantil Studentova rozdělení s 9 stupni volnosti, 95%-ní kvantily Pearsonova a Fisherova-Snedecorova rozdělení):
qt(0.975, df = 9)
qchisq(0.95, df = 9)
qf(0.95, df1 = 3, df2 = 10)
[1] 2.262157
[1] 16.91898
[1] 3.708265
Časté chyby
- Rozptyl vs. směrodatná odchylka v R. Zápis používá rozptyl, ale
dnorm/pnorm/qnormočekávají směrodatnou odchylku. Dosazení rozptylu místo dává jiný — a pro výrazně odlišný — výsledek (viz příklad s ampulkou). - u spojité veličiny je vždy 0. Hustota sama o sobě pravděpodobnost neudává — pravděpodobnost dává až plocha pod křivkou na intervalu.
- Záměna stupňů volnosti u Fisherova-Snedecorova rozdělení. (čitatel) a (jmenovatel) nejsou zaměnitelné —
qf(p, df1, df2)dá jiný výsledek nežqf(p, df2, df1).
Související stránky
- Metody aplikované statistiky
- popisna-statistika
- testovani-hypotez
- regresni-a-korelacni-analyza
- kontingencni-tabulky
- regulacni-diagramy-a-indexy-zpusobilosti
- Tahák pro R
Reference
KROPÁČ, J. Statistika A. 4. vyd. Brno: Fakulta podnikatelská VUT, 2011.