
Regulační diagramy a indexy způsobilosti
Regulační diagramy a indexy způsobilosti
Statistická regulace procesu
Tradiční zabezpečování jakosti kontroluje výrobky až po jejich vyrobení, což je neekonomické. Statistická regulace procesu je preventivní nástroj řízení jakosti: analyzuje chování výrobního procesu, umožňuje včas odhalit odchylky od normy a zasáhnout tak, aby proces zůstal dlouhodobě na požadované a stabilní úrovni — ve statisticky zvládnutém stavu.
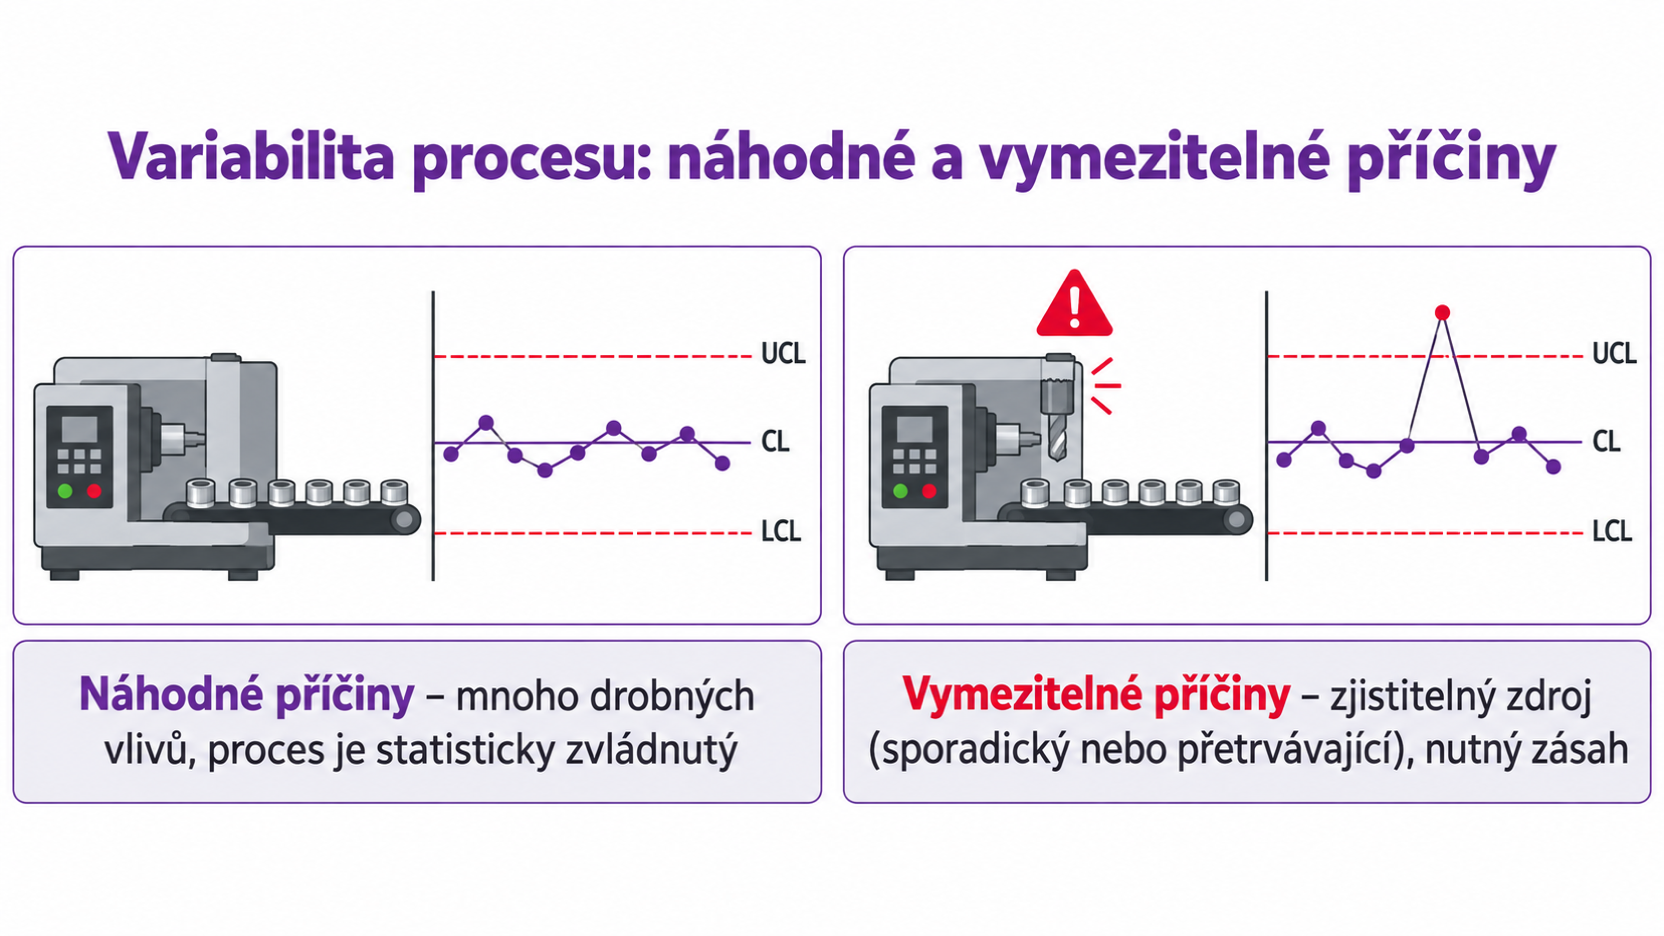
Teorie regulace vychází z variability procesu, kterou způsobují dva druhy příčin:
| Náhodné příčiny | Vymezitelné příčiny | |
|---|---|---|
| Povaha | široká skupina neidentifikovatelných vlivů, každý přispívá k variabilitě malou měrou | vlivy, které za běžných podmínek na proces nepůsobí; vyvolají nepřirozené kolísání údajů |
| Stav procesu | ustálený, jakost výstupů je předvídatelná, není nutné zasahovat — statisticky zvládnutý | jakost výstupů není předvídatelná, je nutné zasáhnout — proces není statisticky zvládnutý |
| Příklady | psychický stav pracovníka, chvění stroje, teplota ovzduší | změna materiálu, nezaškolená obsluha |
Vymezitelné příčiny jsou sporadické (vznikají náhle, změny trvají krátce) nebo přetrvávající (trvají stále nebo se mění).
Regulace probíhá ve třech fázích:
- Fáze přípravná — stanoví se sledované znaky jakosti (rozměr, hmotnost, počet vad…), délka časového intervalu mezi měřeními, logická podskupina (skupina měření, v níž se předpokládá působení pouze náhodných příčin), typ regulačního diagramu a místa kontroly v procesu.
- Fáze zabezpečování statistické zvládnutosti — pomocí regulačních diagramů se identifikují vymezitelné příčiny a odstraní se jejich působení.
- Fáze analýzy a zabezpečení způsobilosti — zkoumá se, zda statisticky zvládnutý proces vyhovuje požadavkům zákazníka; k tomu slouží indexy způsobilosti (níže).
Princip regulačního diagramu
Regulační diagram je grafický prostředek pro zobrazení vývoje variability procesu v čase. Popisuje statistickou zvládnutelnost procesu a dává signál, že na proces začala působit vymezitelná příčina; na jeho základě se do procesu zasáhne s cílem příčinu odstranit.
- CL — střední přímka, odpovídá požadované (referenční) hodnotě použité charakteristiky,
- UCL — horní akční regulační mez,
- LCL — dolní akční regulační mez.
Akční meze vymezují pásmo působení pouze náhodných příčin variability.
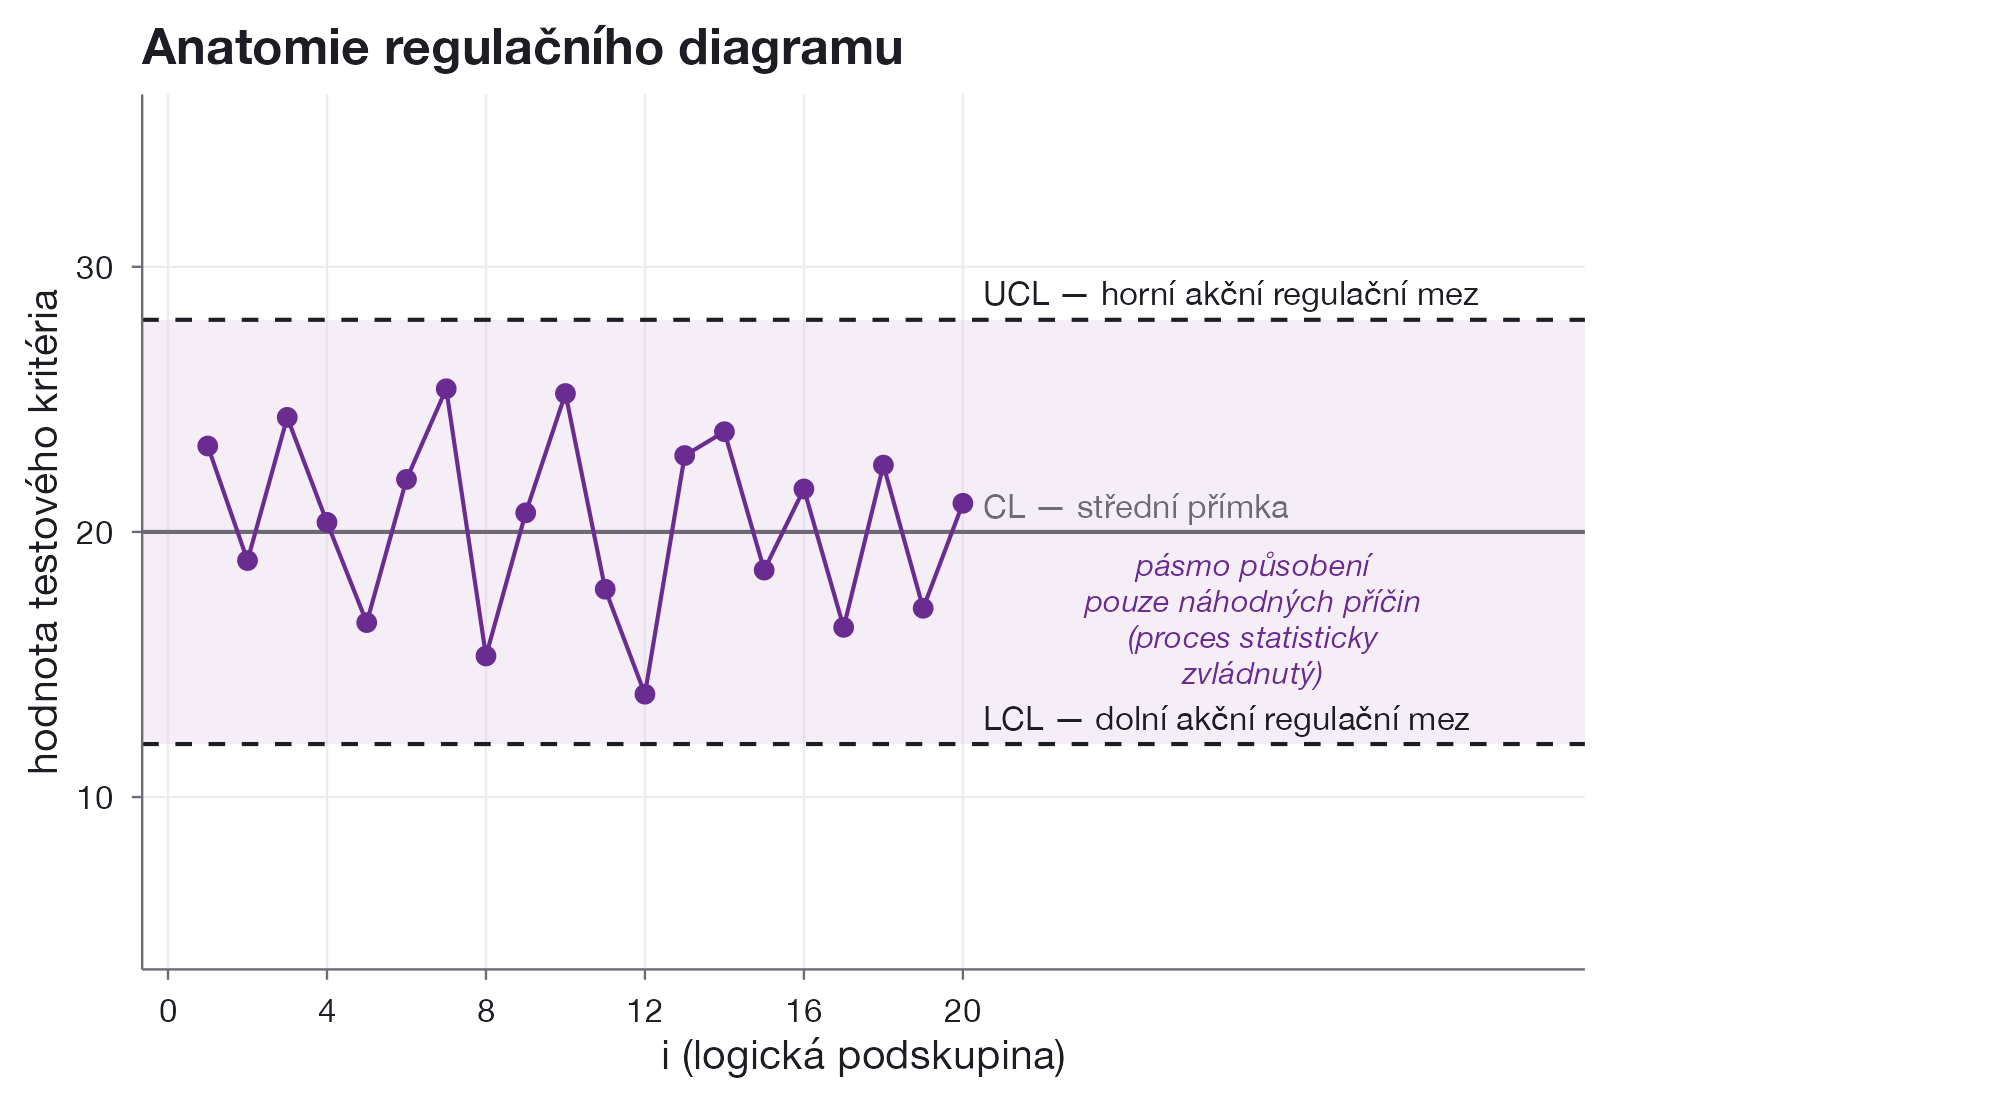
Interpretace: jsou-li všechny body uvnitř akčních mezí, je proces statisticky zvládnutý (nepůsobí žádná vymezitelná příčina). Je-li některý bod mimo meze, lze usuzovat, že proces není ve statisticky zvládnutém stavu; je třeba identifikovat vymezitelnou příčinu a přijmout opatření k jejímu odstranění.
Podle charakteru regulované veličiny se diagramy dělí na diagramy pro regulaci měřením (regulovaná veličina je spojitá náhodná veličina) a pro regulaci srovnáváním (diskrétní náhodná veličina).
Postup při konstrukci regulačního diagramu:
- volba regulované veličiny,
- sběr a záznam dat,
- ověření požadovaných předpokladů o datech,
- volba rozsahu logických podskupin,
- volba vhodného regulačního diagramu,
- výpočet hodnot zvoleného testového kritéria pro jednotlivé výběry,
- ověření a zajištění statistické zvládnutosti procesu,
- ověření způsobilosti procesu,
- vlastní regulace procesu.
Regulace měřením
Diagramy pro regulaci měřením se používají, když je regulovaná veličina měřitelná. Požaduje se, aby:
- jednotlivá měření byla vzájemně nezávislá,
- regulovaná veličina byla spojitá náhodná veličina s normálním rozdělením se střední hodnotou a směrodatnou odchylkou — tyto dva parametry charakterizují statistickou stabilitu procesu; je hodnota, na niž je proces nastaven, charakterizuje jeho přesnost.
Jsou-li předpoklady splněny, volí se diagramy, které současně sledují stabilitu polohy i stabilitu rozptylu: , a . Výsledkem jsou vždy dva diagramy.
Diagram
Regulované veličiny jsou výběrové průměry a výběrová rozpětí v logických podskupinách:
Podmínky použití: regulovaná veličina je měřitelná a má normální rozdělení, jednotlivá měření jsou nezávislá, každá logická podskupina má stejný rozsah aspoň dvou měření. Má-li každá podskupina aspoň 4 měření, lze diagram pro výběrový průměr použít i pro data, která nepocházejí z normálního rozdělení.
Data se zapisují do tabulky: řádek je logická podskupina v pořadí, v jakém byla získána, sloupce obsahují naměřených hodnot a poslední dva sloupce a . Pro sestrojení diagramu je potřeba aspoň 20 podskupin. Nejprve se určí diagram , potom diagram — u obou střední přímka a akční meze. V R se diagramy konstruují funkcí qcc().
| 1 | 106 | 98 | 101 | 101 |
| 2 | 95 | 94 | 108 | 92 |
| 3 | 122 | 105 | 103 | 133 |
| 4 | 113 | 71 | 128 | 135 |
| 5 | 101 | 92 | 103 | 92 |
| 6 | 98 | 103 | 97 | 99 |
| … | … | … | … | … |
| 19 | 128 | 133 | 120 | 125 |
| 20 | 98 | 103 | 97 | 99 |
Pro každou podskupinu se dopočítá výběrový průměr a rozpětí :
| 1 | 101,50 | 8 |
| 2 | 97,25 | 16 |
| 3 | 115,75 | 30 |
| 4 | 111,75 | 64 |
| 5 | 97,00 | 11 |
| 6 | 99,25 | 6 |
| … | … | … |
| 19 | 126,50 | 13 |
| 20 | 99,25 | 6 |
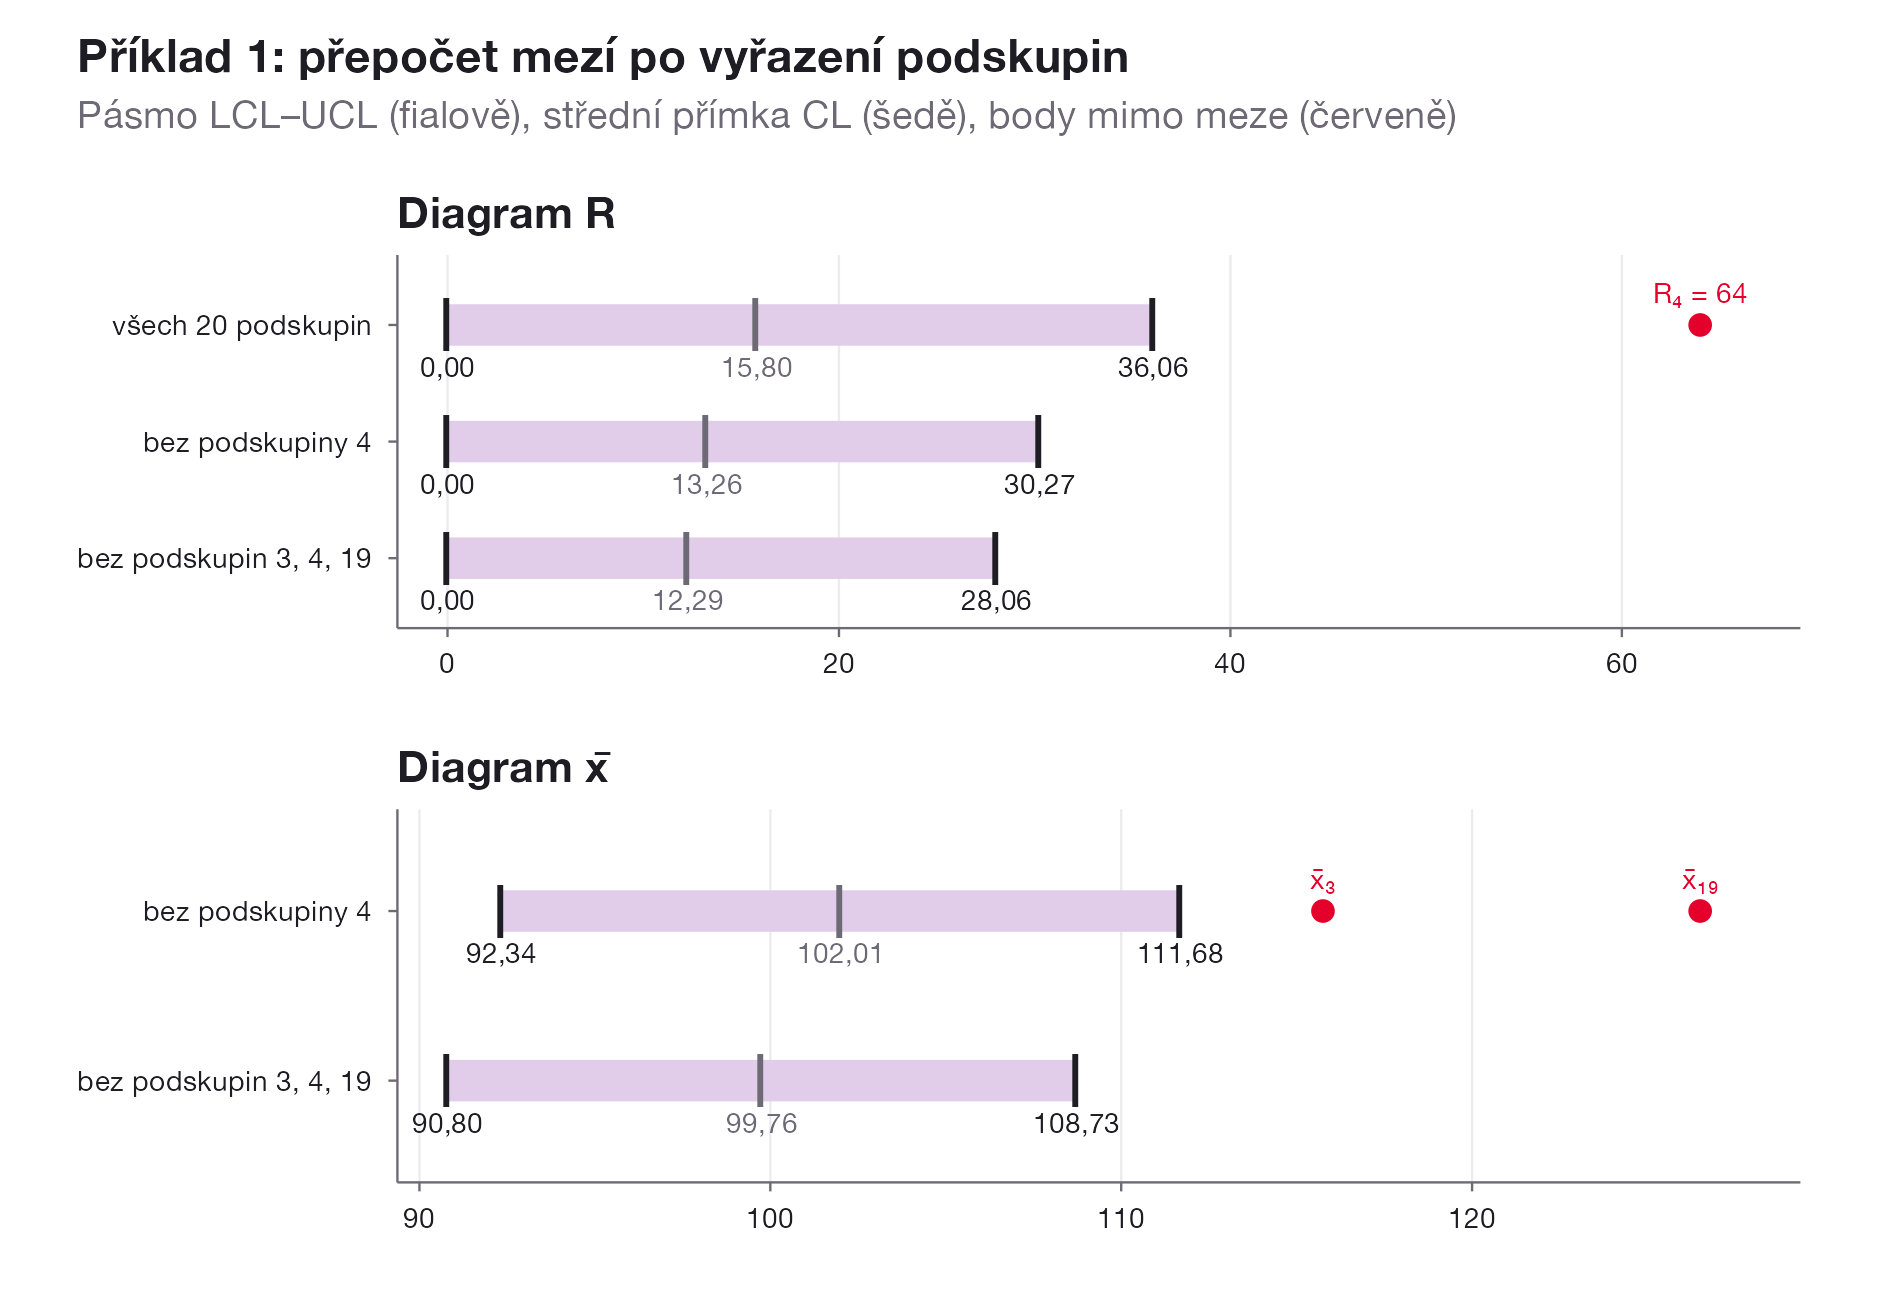
Nejprve se posoudí diagram na všech 20 podskupinách: , , . Rozpětí čtvrté podskupiny () mez překračuje; po potvrzení vymezitelné příčiny se podskupina 4 z výpočtu vyřadí a meze se přepočítají — , , . Diagram rozpětí je teď zvládnutý, lze tedy posoudit diagram .
Diagram bez čtvrté podskupiny dává , , . Mez teď překračují průměry podskupin 3 a 19. Po potvrzení vymezitelné příčiny se vyřadí obě najednou a meze diagramu se přepočítají bez podskupin 3, 4 a 19: , , — žádná z 17 zbývajících podskupin mez nepřekračuje.
Konečný diagram na stejných 17 podskupinách má , , — všechny výběrové průměry leží uvnitř mezí, proces je zvládnutý. Protože bylo vyřazeno několik podskupin, je vhodné měření doplnit tak, aby se pracovalo s počtem podskupin mezi 20 a 25.
V R se diagramy sestrojí funkcí qcc() z balíčku qcc. Data jsou tabulka, v níž řádek odpovídá logické podskupině a sloupce jednotlivým měřením:
library(qcc)
data <- read.table("3_2.txt", header = TRUE)
qcc(data, type = "R")      # diagram R
qcc(data, type = "xbar")   # diagram x̄
Funkce vykreslí diagram se střední přímkou a akčními mezemi a body mimo meze zvýrazní. Podskupina s potvrzenou vymezitelnou příčinou se vyřadí z dat (například data[-4, ]) a diagram se sestrojí znovu.
Diagram
Regulované veličiny jsou výběrové průměry a výběrové směrodatné odchylky v logických podskupinách. Podmínky použití jsou stejné jako u , logické podskupiny ale sestávají z většího počtu měření. Data se zapisují do obdobné tabulky.
data <- read.table("3_2.txt", header = TRUE)
qcc(data, type = "S")      # diagram s
qcc(data, type = "xbar")   # diagram x̄
Diagram
Používá se za stejných podmínek jako , ale v každé logické podskupině se provede jen jedno měření — například proto, že náklady na kontrolu jsou vysoké nebo kontrola trvá dlouho. Charakteristikou rozptylu je pak klouzavé rozpětí:
Regulované veličiny jsou hodnoty a ; nejdříve se určí střední přímka a meze diagramu , potom diagramu . Data jsou jeden vektor naměřených hodnot:
data <- read.table("3_3.txt", header = TRUE)
qcc(data[, 1], type = "xbar.one")
Regulace srovnáváním
Diagramy pro regulaci srovnáváním se používají, sledují-li se počty neshodných produktů nebo počty neshod na produktech — regulovaná veličina je diskrétní náhodná veličina.
| Sleduje se | Konstantní rozsah podskupin | Nekonstantní rozsah podskupin |
|---|---|---|
| počet neshod na produktech (např. vady na stejných tabulích skla) | ||
| počet neshodných produktů ve výběru (např. neshodné kusy ze série na výrobní lince) |
Diagram
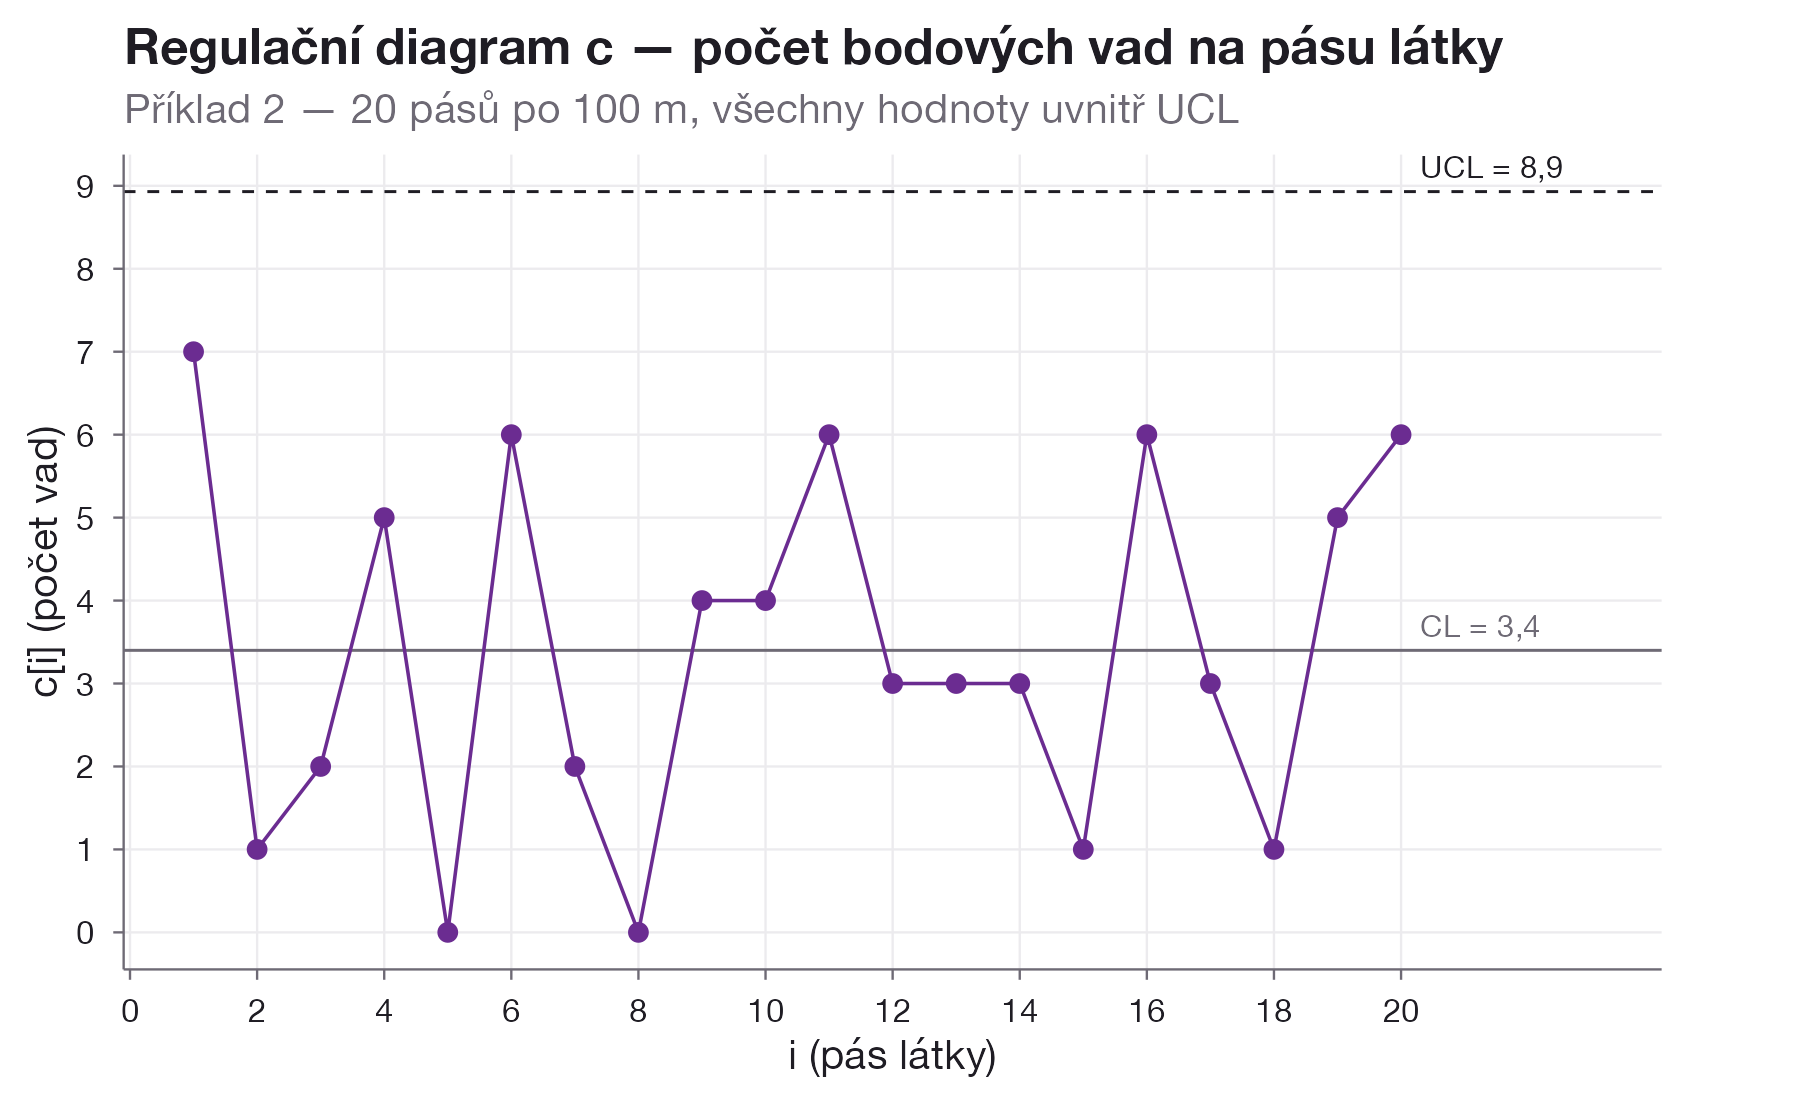
Regulovanou veličinou je počet neshod na produktech v -té logické podskupině, ; v každé podskupině je stejný počet produktů. Počet neshod má Poissonovo rozdělení, pokud může být počet neshod na produktu teoreticky neohraničený a pravděpodobnost více než jedné neshody v určitém místě produktu je zanedbatelná.
c_i <- c(7, 1, 2, 5, 0, 6, 2, 0, 4, 4, 6, 3, 3, 3, 1, 6, 3, 1, 5, 6)

q_c <- qcc(c_i, type = "c")
summary(q_c)
Call:
qcc(data = c_i, type = "c")

c chart for c_i

Summary of group statistics:
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
   0.00    1.75    3.00    3.40    5.25    7.00

Group sample size:  1
Number of groups:  20
Center of group statistics:  3.4
Standard deviation:  1.843909

Control limits:
 LCL      UCL
   0 8.931727
Průměrný počet vad na pás je , horní mez a dolní mez . Žádný pás meze nepřekračuje — proces je zvládnutý.
Diagram
Regulovanou veličinou je průměrný počet neshod přepočítaný na jeden produkt z logické podskupiny; rozsah podskupin není konstantní, a proto se bod od bodu mění i meze.
Za sizes se dosadí vektor rozsahů jednotlivých logických podskupin, resp. rozměr jejich jednotek:
data <- read.table("3_4.txt", header = TRUE)   # počty suků a rozměry prken
qcc(data[, 1], type = "u", sizes = data[, 2])
Diagram
Regulovanou veličinou je počet neshodných produktů (ne neshod) v logické podskupině. Podmínky použití: rozsahy podskupin jsou stejně velké a velké (alespoň 50 produktů). Počet neshodných produktů má pak přibližně binomické rozdělení se střední hodnotou , kde je pravděpodobnost, že vyrobený produkt je neshodný.
Pro konstantní rozsah :
data <- read.table("3_7.txt", header = TRUE)   # počty vadných tabletů v sériích po 100 kusech
qcc(data[, 1], type = "np", sizes = 100)
Diagram
Regulovanou veličinou je počet neshodných produktů v logické podskupině přepočtený na jednotku, ; rozsahy podskupin nemusí být konstantní.
Za sizes se dosadí vektor rozsahů logických podskupin:
data <- read.table("3_6.txt", header = TRUE)   # počty vadných tabletů a rozsahy sérií
qcc(data[, 1], type = "p", sizes = data[, 2])
Indexy způsobilosti
Zatímco regulační diagram posuzuje stabilitu procesu v čase, index způsobilosti posuzuje, zda se zvládnutý proces svou přirozenou variabilitou vejde do tolerančních mezí zadaných specifikací — dolní meze a horní meze . Způsobilost se zkoumá až pro proces, který je podle regulačních diagramů statisticky zvládnutý (třetí fáze regulace).
— index způsobilosti
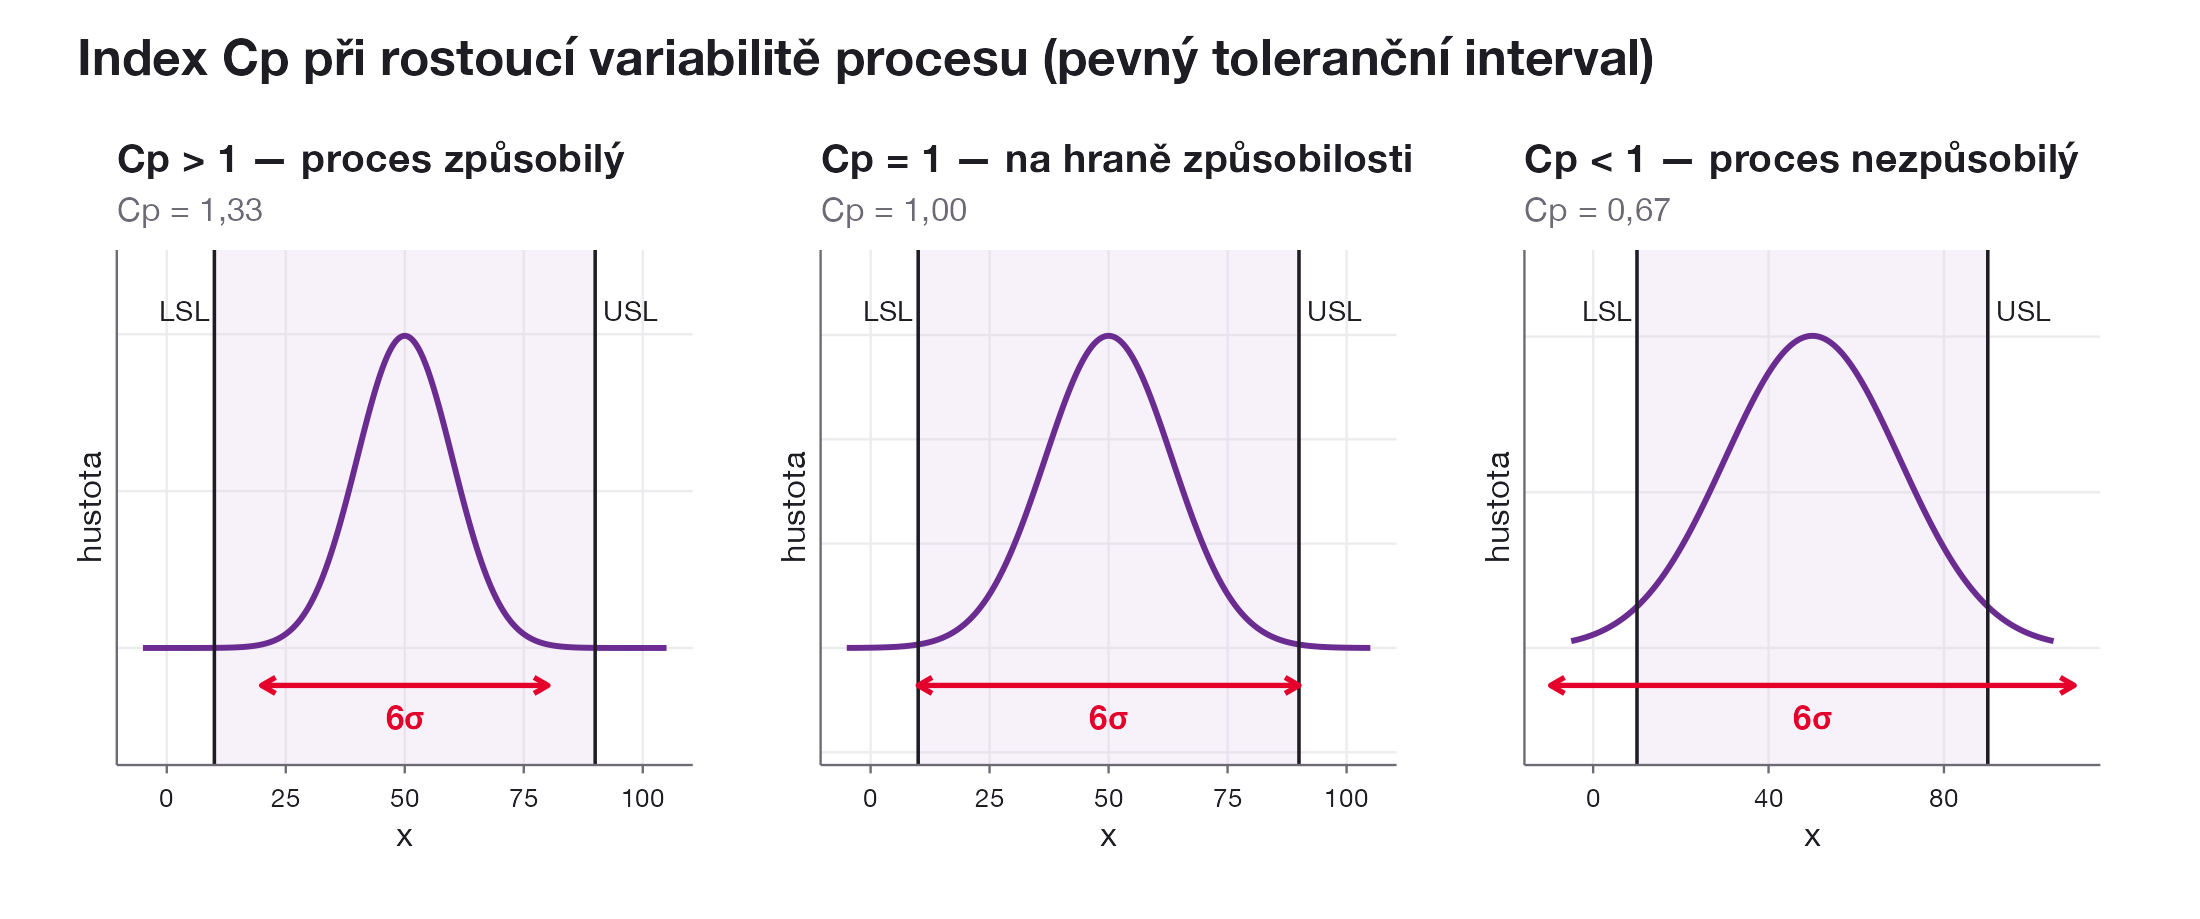
Podíl mezi délkou tolerančního intervalu a délkou intervalu, ve kterém by za normálního rozdělení mělo ležet skoro všech 99,73 % hodnot znaku, tedy :
srovnává jen délky, nevšímá si, kde uprostřed tolerance proces leží — centrovaný i silně vychýlený proces se stejným mají stejné .
Doplňkové charakteristiky využití tolerančního intervalu:
- míra využití tolerančního intervalu: — na kolik procent je toleranční interval využíván sledovaným znakem,
- robustnost procesu: rezerva, kterou máme v tolerančních mezích, než index nabyde hodnotu 1 — rovná se menší hodnotě z výrazů a ,
- podíl zmetků: , kde je distribuční funkce normovaného normálního rozdělení.
— index způsobilosti s ohledem na vychýlení
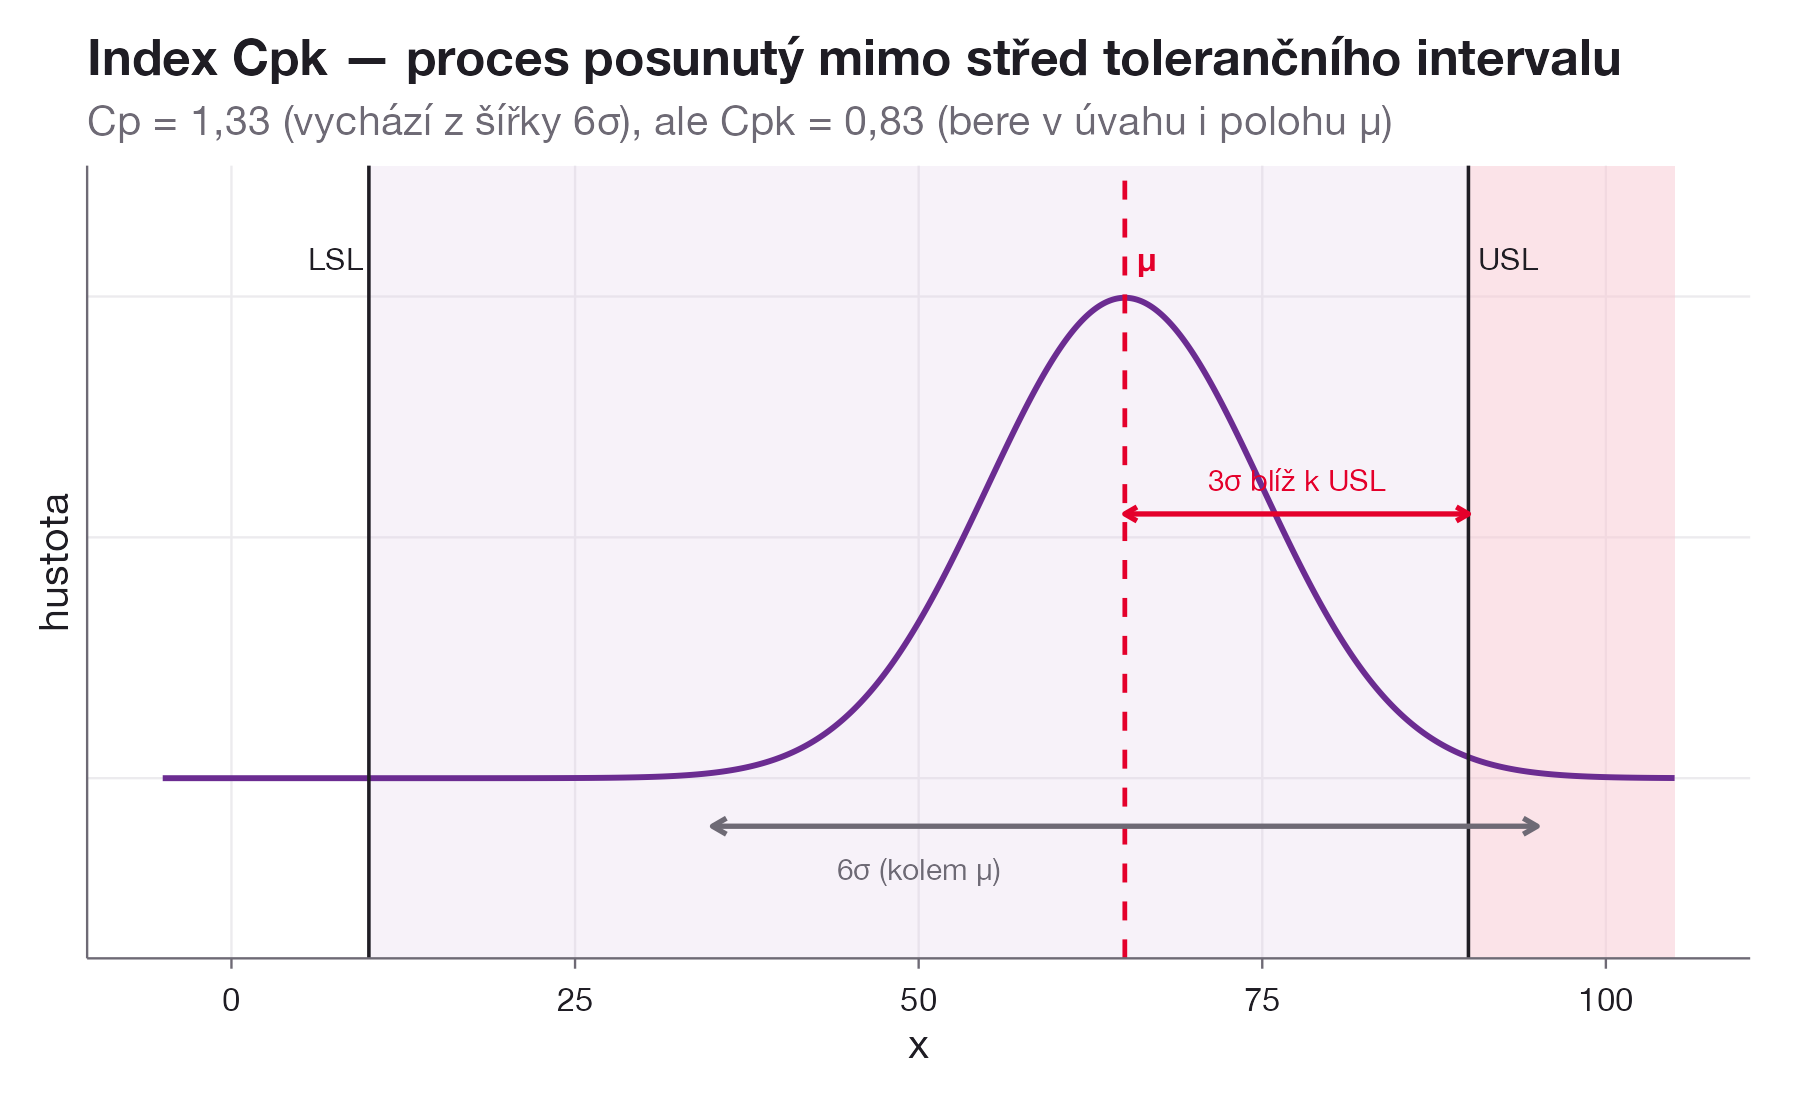
Bere v úvahu, že proces nemusí být centrovaný na střed tolerance; počítá se samostatně vzdálenost k horní a dolní mezi a horší z obou se stane indexem:
Vyjde-li některý z obou podílů záporný, položí se roven nule; to nastane, když střední hodnota leží mimo toleranční interval, a proces pak není pod statistickou kontrolou. U centrovaného procesu jsou oba podíly stejné a ; čím víc je proces vychýlený, tím víc je menší než .
a — indexy vztažené k cíli
Pokud má proces zadaný cílový střed (ne nutně střed tolerance), nahradí se odmocninou ze střední čtvercové odchylky od cíle , která trestá i vychýlení od :
Interpretace
| Hodnota | Způsobilost procesu |
|---|---|
| dosahovaná přesnost je menší než předepsaná — proces je nezpůsobilý | |
| dosahovaná přesnost je rovna předepsané — proces je způsobilý, ale sebemenší zvětšení jej posune na nezpůsobilý | |
| dosahovaná přesnost je větší než předepsaná — proces je způsobilý |
U indexu se v praxi požaduje víc než jen hodnota nad 1: s rozvojem technologií roste nárok na rezervu, a běžně se dnes vyžaduje hodnota alespoň .
Výpočet v R
Indexy způsobilosti počítá process.capability() z výstupu regulačního diagramu q; spec.limits jsou toleranční meze a , target cílová hodnota . Pro velikost výrobku v mm s tolerančními mezemi 100 a 110 mm a cílovou hodnotou 105 mm:
library(qcc)
data <- read.table("3_8.txt", header = TRUE)
x <- as.matrix(data)
q <- qcc(x, type = "xbar")
process.capability(q, spec.limits = c(100, 110), target = 105, std.dev = sd(x))
Výpis obsahuje řádky Cp, Cp_l, Cp_u, Cp_k a Cpm s hodnotou indexu a 95% intervalem spolehlivosti. Cp_l a Cp_u jsou dílčí poměry k dolní a horní mezi, jejich minimum je . Index a doplňkové charakteristiky se dopočítají ze vzorců výše:
mu <- mean(x); sigma <- sd(x)
LSL <- 100; USL <- 110; T <- 105
tau <- sqrt(sigma^2 + (mu - T)^2)
Cp <- (USL - LSL) / (6 * sigma)
Cpmk <- min((USL - mu) / (3 * tau), (mu - LSL) / (3 * tau))
miravyuziti <- 100 / Cp
robustnost <- min(USL - (mu + 3 * sigma), (mu - 3 * sigma) - LSL)
Pz <- 2 * pnorm(-3 * Cp)
Časté chyby
- Počítat indexy způsobilosti pro proces, který není statisticky zvládnutý — způsobilost se zkoumá až ve třetí fázi regulace.
- Posuzovat jen u vychýleného procesu — polohu střední hodnoty nezohledňuje, vychýlení zachytí až .
- Zaměnit diagram s diagramem nebo diagram s diagramem — při nekonstantním rozsahu podskupin se volí , resp. , a do
sizesse zadává vektor rozsahů. - Posuzovat diagram dřív než diagram rozpětí — nejprve se určí a stabilizuje diagram (resp. ), potom diagram .
- Vyřadit podskupinu jen podle polohy bodu — vyřazuje se až po zjištění a odstranění vymezitelné příčiny.
Související stránky
- Metody aplikované statistiky
- popisna-statistika
- nahodne-veliciny-a-rozdeleni
- testovani-hypotez
- regresni-a-korelacni-analyza
- kontingencni-tabulky
- Tahák pro R
Reference
KROPÁČ, J. Statistika A. 4. vyd. Brno: Fakulta podnikatelská VUT, 2011.
MONTGOMERY, D. C. Introduction to Statistical Quality Control. 6. vyd. John Wiley & Sons, 2005.
ČSN ISO 8258. Shewhartovy regulační diagramy. Praha: Český normalizační institut, 1994.
KUPKA, K. Statistické řízení jakosti. Pardubice: TriloByte, 1997.