
Popisná statistika a datové soubory
Popisná statistika a datové soubory
Základní pojmy
Metody aplikované statistiky pracuje s datovými soubory — konkrétními hodnotami, které popisují vlastnost zkoumaných prvků.
- Základní soubor — množina prvků, na nichž provádíme šetření (např. všichni výdělečně činní obyvatelé ČR).
- Statistický znak — funkce, která vyjadřuje určitou vlastnost prvku (např. velikost platu). Znaky dělíme na:
- kvantitativní (vyjádřitelné číslem) — dále diskrétní (spočetně mnoho hodnot) nebo spojité (libovolná hodnota v intervalu);
- kvalitativní (vyjádřitelné slovně).
- Výběrový soubor — podmnožina prvků základního souboru, na níž znak skutečně zjišťujeme (např. 5 náhodně vybraných obyvatel).
- Datový soubor — n-tice naměřených hodnot zkoumaného znaku, např. .
- Podle počtu sledovaných znaků rozlišujeme jednorozměrné, dvourozměrné a vícerozměrné datové soubory.
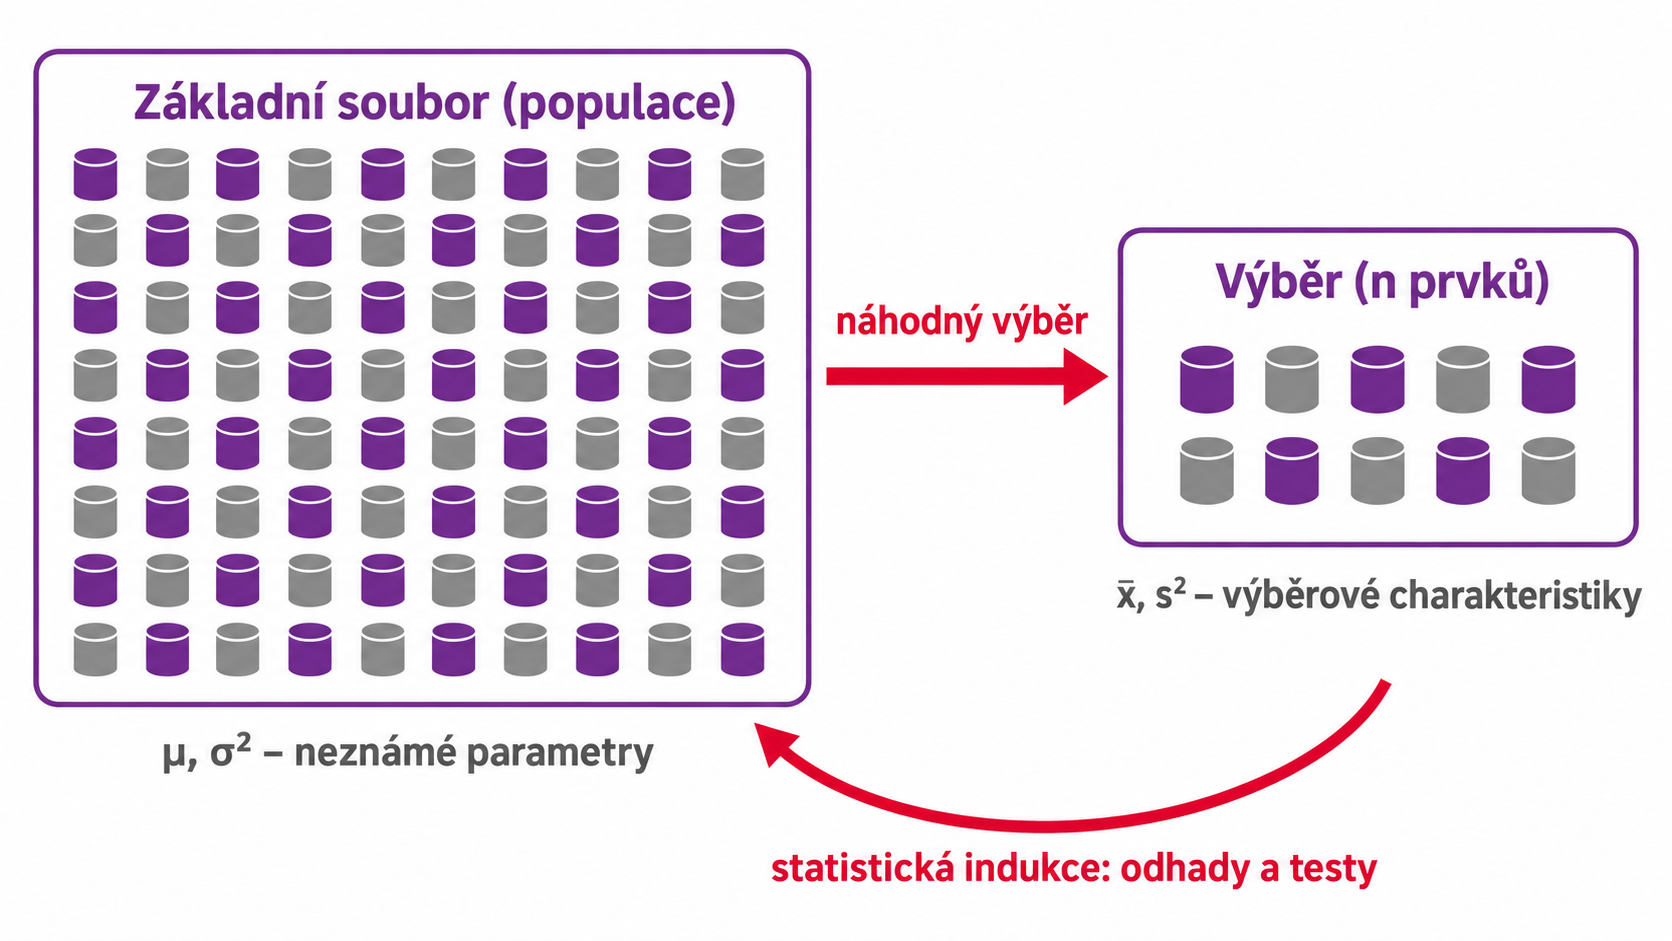
Aby výběrový soubor dobře vypovídal o základním souboru, měl by být reprezentativní (podobný základnímu souboru svým složením). Není-li to možné zajistit přímo, volí se prvky do výběru náhodně — nezávislý výběr. Bez náhodnosti výběru nelze vlastnosti základního souboru správně vystihnout.
Empirické charakteristiky
Zpracováním datového souboru získáme empirické charakteristiky a odhad zákona rozdělení zkoumané náhodné veličiny . Jde o bodové odhady charakteristik ; ruční výpočet podle vzorců níže je potřeba jen bez dostupného softwaru.
Míry polohy
Dalšími mírami polohy jsou medián a modus (nejčetnější hodnota výběru).
Míry variability
Kvantily
Kvantil dělí hodnoty datového souboru na dvě části: hodnot je menších nebo rovných , zbylých je větších. Nejdůležitější kvantily:
- medián — pro lichý počet prvků uspořádaného souboru prostřední prvek, pro sudý počet průměr dvou prostředních prvků;
- dolní kvartil a horní kvartil .
Datový soubor se do R zadává buď přímo (x <- c(...)), nebo načtením ze souboru:
x <- c(4.1, 4.0, 3.8, 3.9, 3.8, 3.8, 3.5, 3.7, 4.0, 4.0)   # přímé zadání hodnot
# x <- read.table("data.txt")[, 1]                       # načtení prvního sloupce ze souboru
Řádek s načtením ze souboru je zakomentovaný znakem #: soubor musí ležet v pracovním adresáři R. read.table() vrací datovou tabulku (data.frame), proto [, 1] vybere její první sloupec jako vektor.
V R:
x <- c(11.1, 12.7, 10.8, 13.2, 12.7, 13.4, 12.7, 14.4, 14.7, 14.4)
length(x)
mean(x)
var(x)
sd(x)
min(x); max(x); max(x) - min(x)
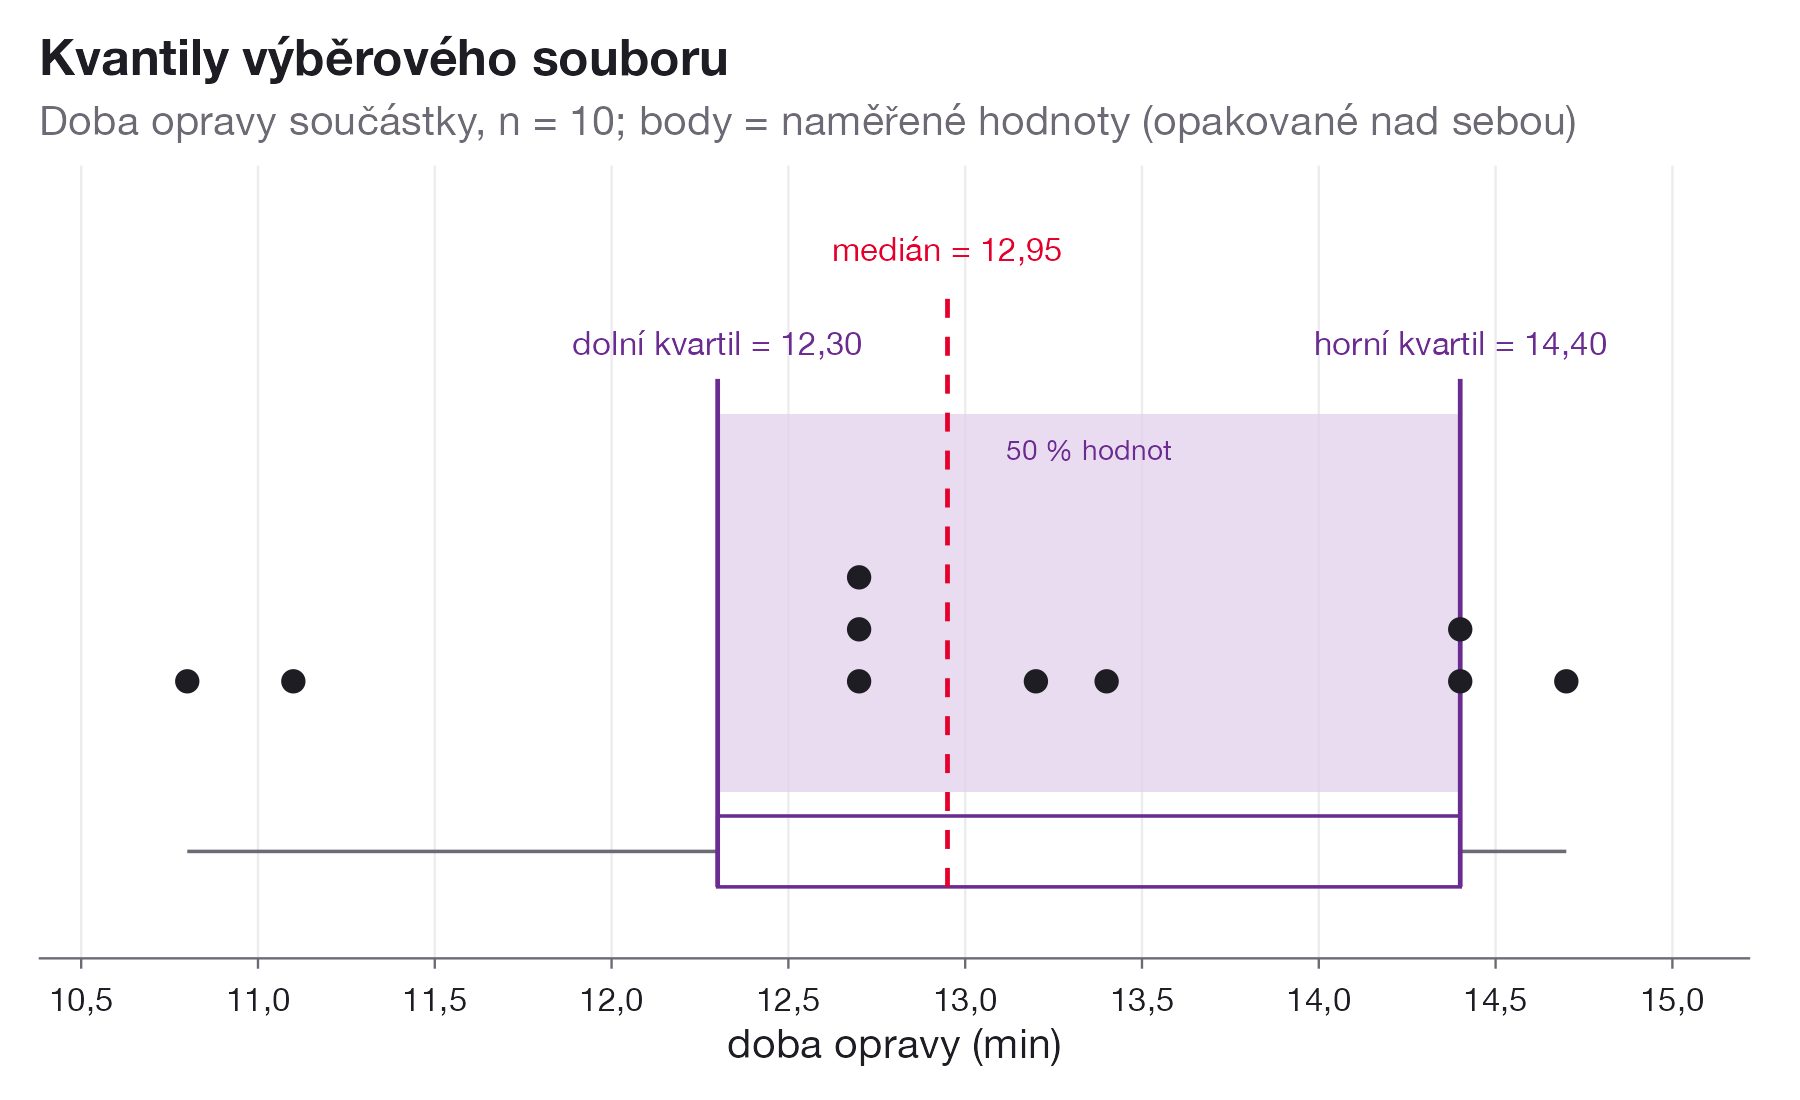
quantile(x, 0.5, type = 6)
quantile(x, 0.25, type = 6)
quantile(x, 0.75, type = 6)
[1] 10
[1] 13.01
[1] 1.747667
[1] 1.321993
[1] 10.8
[1] 14.7
[1] 3.9
  50%
12.95
 25%
12.3
 75%
14.4
quantile(x, p, type = 6) je potřeba zadat explicitně — výchozí typ v R (type = 7) by u některých souborů dal mírně odlišné hodnoty kvantilů než ruční výpočet použitý v této kapitole.
Seřazení souboru a krabicový graf:
sort(x)                     # vzestupně
sort(x, decreasing = TRUE)  # sestupně
boxplot(x)
 [1] 10.8 11.1 12.7 12.7 12.7 13.2 13.4 14.4 14.4 14.7
 [1] 14.7 14.4 14.4 13.4 13.2 12.7 12.7 12.7 11.1 10.8
boxplot() kreslí krabici mezi hodnotami fivenum(x) (zde 12,7 a 14,4), které se od kvartilů typu 6 mohou mírně lišit.
Výstup R kódu výše dává , , , , medián , dolní kvartil , horní kvartil .
Odhad střední doby opravy je přibližně 13 minut, odhad směrodatné odchylky přibližně 1,32 minuty. Odchylka je vzhledem k průměru nízká — data kolísají kolem průměru jen málo. Uspořádaný soubor má medián 12,95: polovina oprav trvala méně, polovina více; 25 % oprav bylo kratších než 12,3 minuty a 75 % kratších než 14,4 minuty.
x6 <- c(44, 40.2, 41.9, 43.4, 42.8, 42.3, 43.2, 45, 41.5, 42.7,
        43.9, 40.1, 43.3, 41.1, 42.5, 42.4, 41.4, 40.8, 42, 44.7,
        41.2, 41.9, 42.4, 44.4, 40.5, 39.7, 41.1, 41, 41.9, 40.8,
        43, 42.8, 42.9, 42.7, 43.3, 42.2, 39.2, 41.5, 41.6, 42.7,
        45, 42.3, 43.6, 43.2, 38.8, 43, 44.2, 43, 40, 44.4)
length(x6)
mean(x6)
sd(x6)
max(x6) - min(x6)
median(x6)
[1] 50
[1] 42.27
[1] 1.48052
[1] 6.2
[1] 42.4
Průměrná doba opravy je 42,27 minuty se směrodatnou odchylkou 1,48 minuty a mediánem 42,4 minuty; průměr a medián téměř splývají, data jsou kolem středu rozložena souměrně.
Empirická distribuční funkce
Pro libovolný rozsah datového souboru, diskrétní i spojitou náhodnou veličinu , lze sestrojit empirickou distribuční funkci . Pro datový soubor je
kde je počet prvků datového souboru menších nebo rovných číslu .
V R:
f <- ecdf(x)
knots(f)        # vzestupně seřazené různé hodnoty datového souboru
f(knots(f))      # hodnoty Fn(x) v těchto bodech
f(13)            # Fn v libovolném bodě
plot(f)
[1] 10.8 11.1 12.7 13.2 13.4 14.4 14.7
[1] 0.1 0.2 0.5 0.6 0.7 0.9 1.0
[1] 0.5
knots() vrací jen různé hodnoty (opakující se hodnota 12,7 je ve výpočtu započtena třikrát, v seznamu uzlů je ale jen jednou); plot(f) nakreslí schodovitý graf, který v každém uzlu skáče o -násobek .
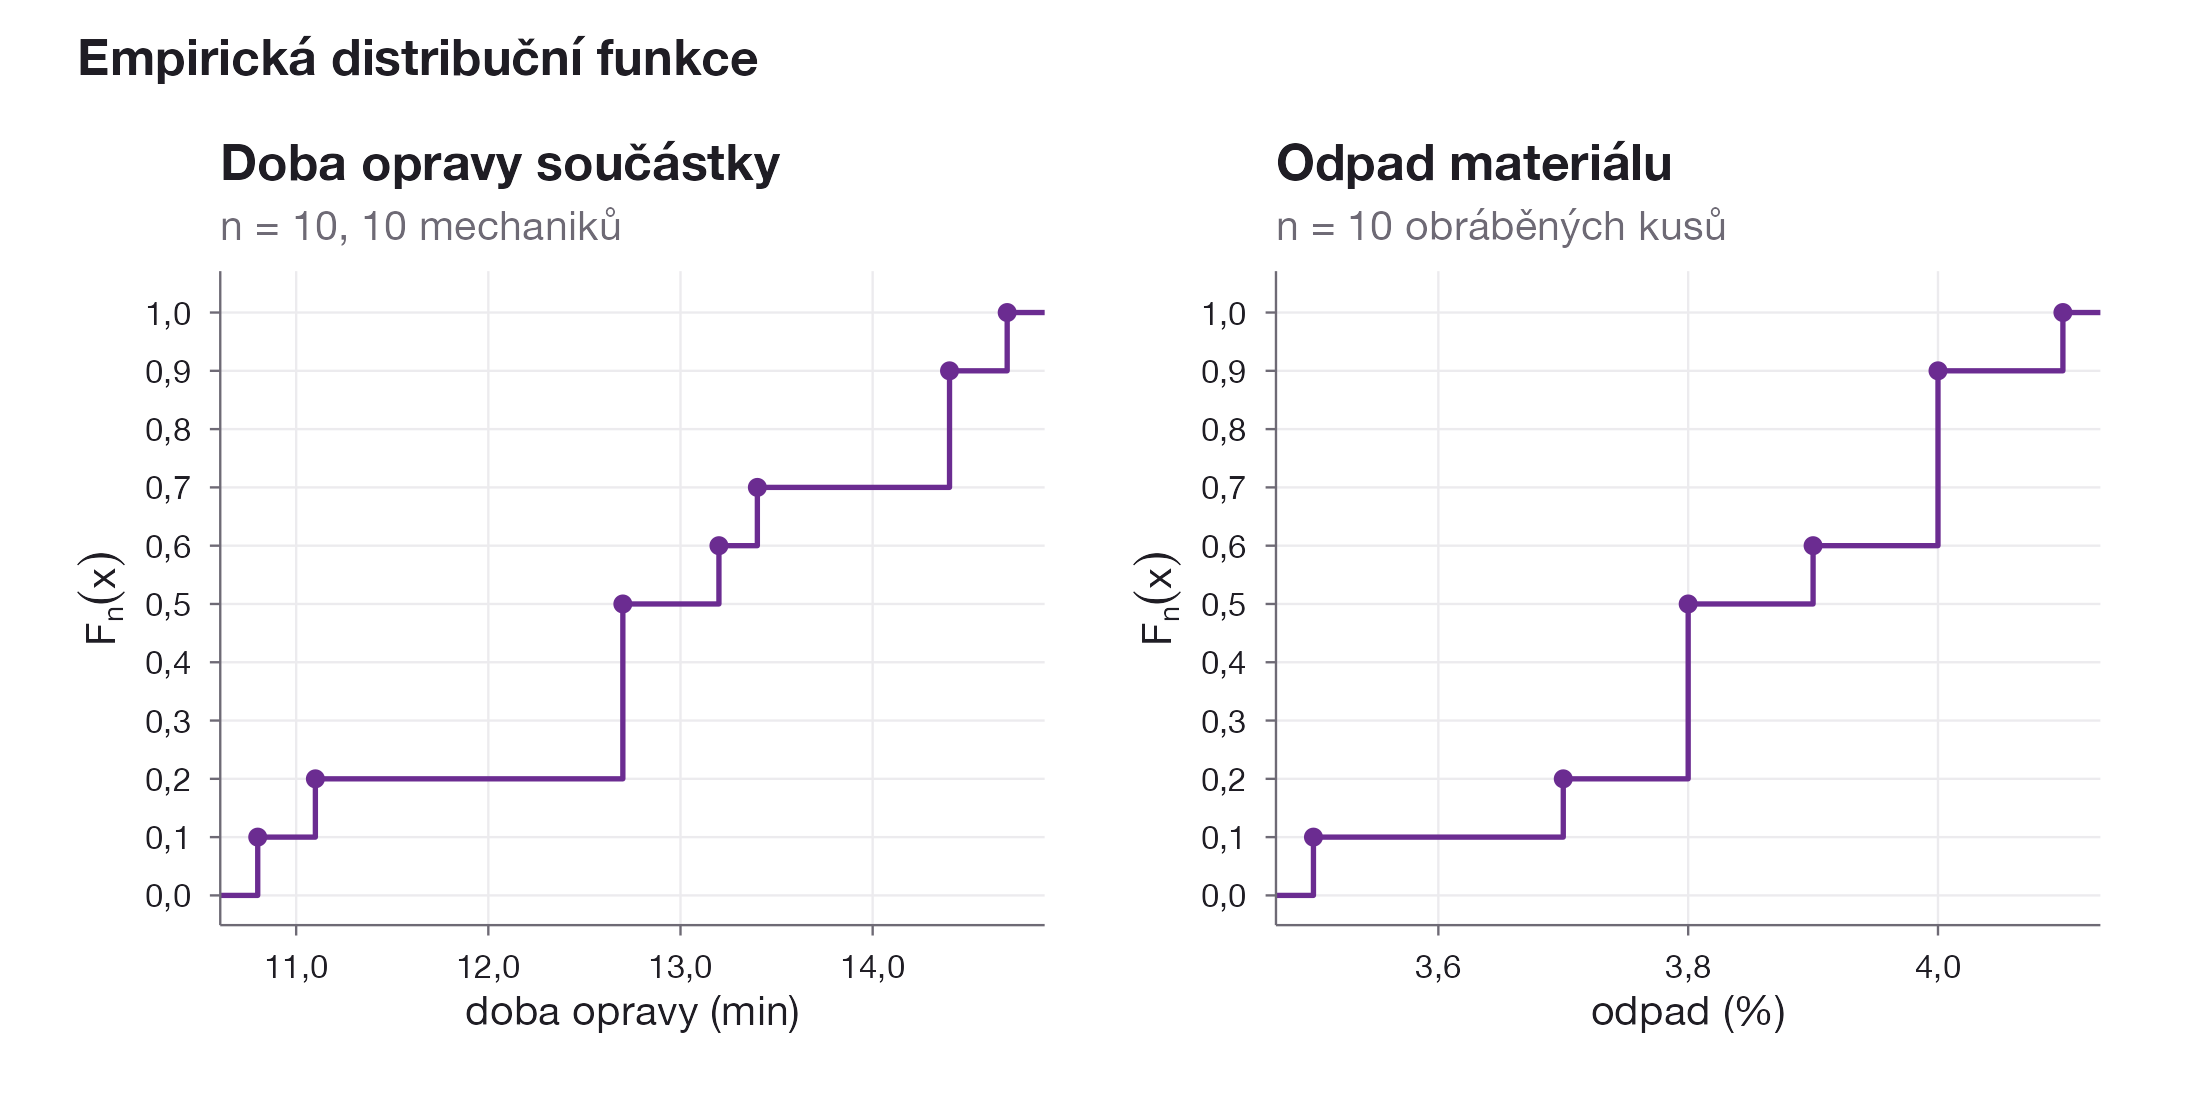
Uspořádaný soubor je .
| 10,8 | 11,1 | 12,7 | 13,2 | 13,4 | 14,4 | 14,7 | |
|---|---|---|---|---|---|---|---|
| 1 | 2 | 5 | 6 | 7 | 9 | 10 | |
| 0,1 | 0,2 | 0,5 | 0,6 | 0,7 | 0,9 | 1,0 |
Graf (levý panel výše) odpovídá tabulce: funkce je nulová pod 10,8, skáče o v každé jednoduché hodnotě a o v bodě 12,7, kde se hodnota opakuje třikrát.
x4 <- c(4.1, 4.0, 3.8, 3.9, 3.8, 3.8, 3.5, 3.7, 4.0, 4.0)
length(x4)
mean(x4)
sd(x4)
max(x4) - min(x4)
median(x4)
f4 <- ecdf(x4)
knots(f4)
f4(knots(f4))
[1] 10
[1] 3.86
[1] 0.1776388
[1] 0.6
[1] 3.85
[1] 3.5 3.7 3.8 3.9 4.0 4.1
[1] 0.1 0.2 0.5 0.6 0.9 1.0
Průměrný odpad je 3,86 % se směrodatnou odchylkou 0,18 % a mediánem 3,85 %. Pravý panel obrázku výše ukazuje tvar : hodnota 3,8 se v souboru opakuje třikrát, proto zde funkce skáče o 0,3 najednou, stejně jako hodnota 4,0.
Třídění datového souboru do tříd
Je-li rozsah datového souboru velký (řádově přes 30 až 50 pozorování), hodnoty se před dalším zpracováním roztřídí: variační rozpětí se rozdělí na určitý počet tříd (intervalů) a zjistí se, kolik hodnot do které třídy padne. Na počet ani šířku tříd neexistuje obecný předpis — počet by neměl být ani příliš malý, ani příliš velký.
Výsledkem je tabulka četností se sloupci:
- — -tý interval (v této kapitole vždy zleva uzavřený a zprava otevřený, ),
- — střed (reprezentant) intervalu,
- — četnost, počet hodnot v intervalu,
- — relativní četnost, přičemž a .
V R se třídění provádí příkazem hist() — buď necháme R zvolit třídy samo (hist(x)), nebo zadáme hranice přímo (hist(x, br = seq(0, 550, by = 50))). Uložením výsledku do proměnné (y <- hist(...)) získáme jednotlivé sloupce tabulky: y$counts (), y$breaks (hranice tříd), y$mids () a y$density (relativní četnosti na škále hustoty).
Interval je ve výchozím nastavení hist() zleva otevřený a zprava uzavřený, — opačně, než jak třídy zapisujeme v této kapitole. Parametr right = FALSE třídy obrátí na .
x9 <- c(101, 338, 150, 47, 10, 2, 12, 392, 5, 73,
        367, 54, 114, 213, 71, 341, 313, 112, 343, 151,
        9, 160, 18, 113, 77, 71, 159, 12, 119, 130,
        140, 161, 379, 54, 373, 168, 365, 110, 145, 88,
        74, 46, 246, 259, 19, 119, 48, 3, 163, 179,
        194, 33, 49, 501, 193, 19, 5, 2, 221, 300,
        88, 13, 428, 249, 25, 209, 54, 91)
length(x9)
max(x9) - min(x9)
y9 <- hist(x9, br = seq(0, 550, by = 50), right = FALSE, plot = FALSE)
y9$counts
round(y9$counts / length(x9), 3)
mean(x9); sd(x9)
[1] 68
[1] 499
 [1] 19 11 10 10  5  1  5  5  1  0  1
 [1] 0.279 0.162 0.147 0.147 0.074 0.015 0.074 0.074 0.015 0.000 0.015
[1] 145.4412
[1] 126.1283
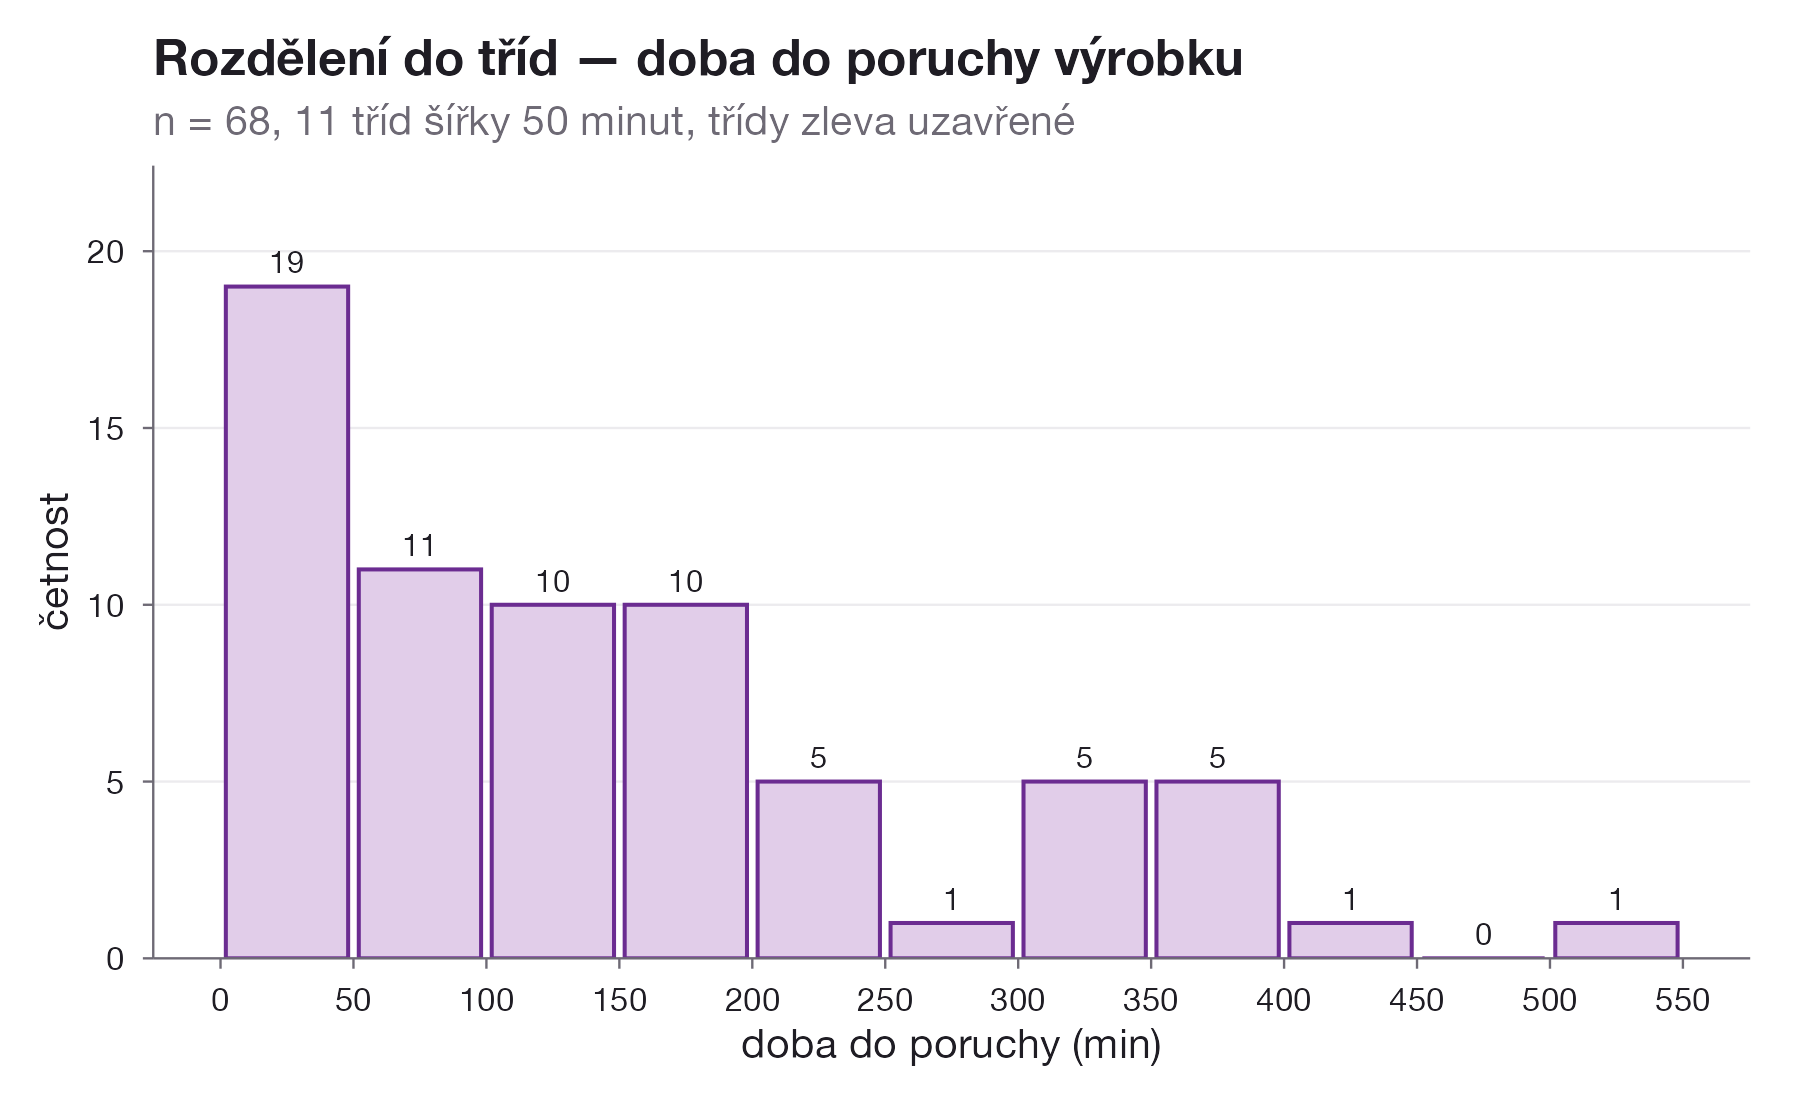
Variační rozpětí je minut; rozdělit je na 11 tříd po 50 minutách je rozumná volba (ani moc málo, ani moc tříd). Výsledná tabulka četností:
| 1 | ⟨0; 50) | 25 | 19 | 0,279 |
| 2 | ⟨50; 100) | 75 | 11 | 0,162 |
| 3 | ⟨100; 150) | 125 | 10 | 0,147 |
| 4 | ⟨150; 200) | 175 | 10 | 0,147 |
| 5 | ⟨200; 250) | 225 | 5 | 0,074 |
| 6 | ⟨250; 300) | 275 | 1 | 0,015 |
| 7 | ⟨300; 350) | 325 | 5 | 0,074 |
| 8 | ⟨350; 400) | 375 | 5 | 0,074 |
| 9 | ⟨400; 450) | 425 | 1 | 0,015 |
| 10 | ⟨450; 500) | 475 | 0 | 0,000 |
| 11 | ⟨500; ∞) | 525 | 1 | 0,015 |
Asi 27,9 % výrobků vydrželo méně než 50 minut, jen asi 1,5 % mezi 250 a 300 minutami. Charakteristiky spočtené ze středů tříd (vážený průměr a rozptyl se střední hodnotou nahrazenou ) vycházejí , , — blízko hodnotám , spočteným přímo z nerozdělených dat; malý rozdíl vzniká tím, že třídění nahrazuje skutečné hodnoty středy tříd.
Tvar histogramu — vysoká četnost u krátkých dob, rychlý pokles — odpovídá exponenciálnímu rozdělení, které se pro dobu do poruchy používá nejčastěji. Jeho hustota je pro , s parametrem odhadnutým jako (v R je rate parametrem dexp()):
rate9 <- 1 / mean(x9)
rate9
[1] 0.006875632
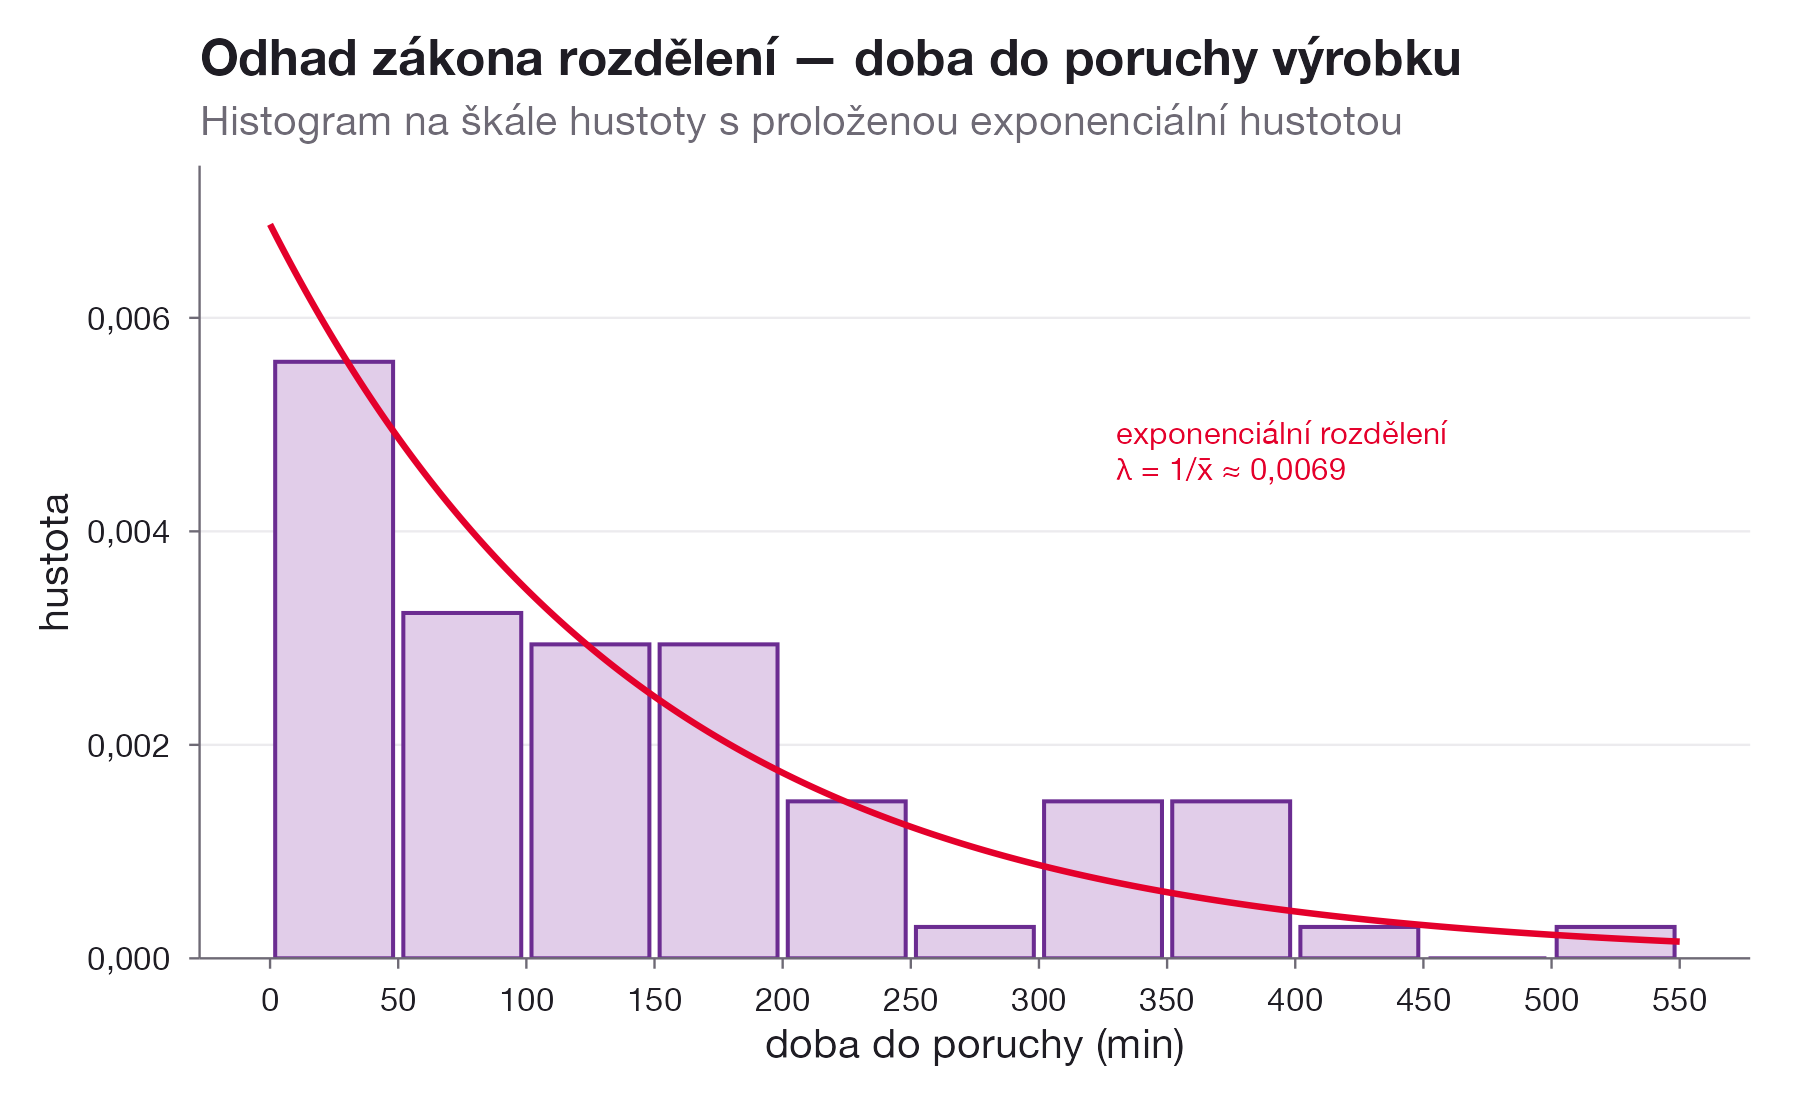
Proložená křivka dobře sleduje tvar sloupců. Zda data odpovídají exponenciálnímu rozdělení formálně, posuzuje test dobré shody popsaný v Testování statistických hypotéz.
x5 <- c(63, 156, 184, 786, 822, 278, 15, 561, 229, 8,
        4, 35, 73, 203, 178, 323, 275, 176, 427, 196,
        415, 140, 17, 293, 991, 100, 189, 176, 672, 134,
        529, 310, 22, 69, 130, 272, 117, 169, 466, 286,
        46, 236, 387, 92, 177, 188, 124, 385, 174, 23)
length(x5)
mean(x5); sd(x5); median(x5)
max(x5) - min(x5)
y5 <- hist(x5, br = seq(0, 1050, by = 150), right = FALSE, plot = FALSE)
y5$mids
y5$counts
round(y5$counts / length(x5), 3)
[1] 50
[1] 246.42
[1] 220.0209
[1] 181
[1] 987
[1]   75 225 375 525 675 825 975
[1] 18 19  6  3  1  2  1
[1] 0.36 0.38 0.12 0.06 0.02 0.04 0.02
Variační rozpětí 987 minut rozdělené do 7 tříd po 150 minutách dává podobný tvar jako u předchozího příkladu: 74 % výrobků vydrželo méně než 300 minut, ojedinělé hodnoty sahají až k 991 minutám. Průměr 246,4 minuty leží výrazně nad mediánem 181 minut — rozdělení je zešikmené k vyšším hodnotám stejně jako u doby do poruchy výše.
Časté chyby
- Výchozí typ kvantilu v R.
quantile()bez argumentutypepoužívá jiný výpočetní vzorec (type = 7) než ruční postup v této kapitole — u některých souborů se hodnoty liší. Pro shodu s ručním výpočtem zadávejtequantile(x, p, type = 6). - Výchozí ohraničení tříd v
hist(). Bezright = FALSEjsou třídy zprava uzavřené, — opačně než konvence použitá v tabulkách výše. Hodnota ležící přesně na hranici pak spadne do jiné třídy a četnosti vyjdou jinak. - Rozptyl vs. směrodatná odchylka. se udává v jednotkách znaku na druhou, ve stejných jednotkách jako data — pro interpretaci (např. „kolísání kolem průměru") patří vždy , ne .
- Příliš mnoho nebo příliš málo tříd. Málo tříd skryje tvar rozdělení, moc tříd rozmělní četnosti na jednotky a histogram je nečitelný; volí se kompromis, ne pevné pravidlo.
Související stránky
- Metody aplikované statistiky
- Náhodné veličiny a rozdělení pravděpodobnosti
- Testování statistických hypotéz
- Regresní a korelační analýza
- Kontingenční tabulky
- Regulační diagramy a indexy způsobilosti
- Tahák pro R
Reference
KROPÁČ, J. Statistika A. 4. vyd. Brno: Fakulta podnikatelská VUT, 2011.