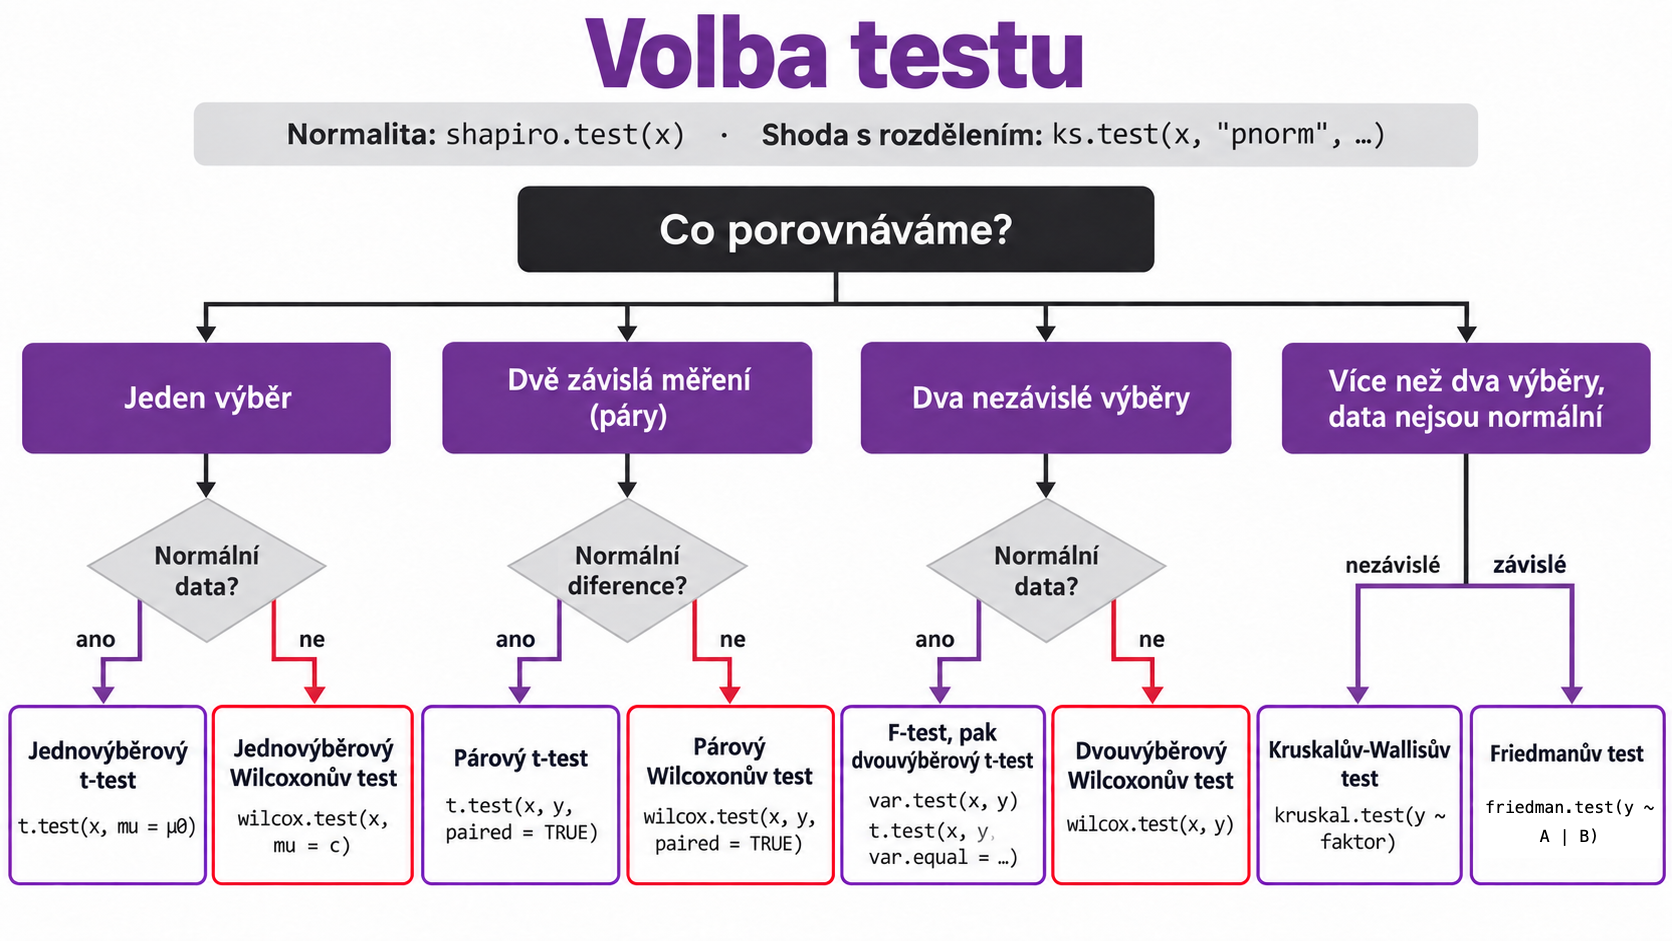
Referenční přehled příkazů R používaných v kurzu Metody aplikované statistiky : načtení dat, volba statistického testu podle situace, funkce jednotlivých kapitol a výchozí hodnoty parametrů R, které mění výsledek.
Data se do R zadávají buď přímo jako vektor, nebo se načtou ze souboru v pracovním adresáři či vybraného v dialogovém okně:
R
x <- c ( 4.1 , 4.0 , 3.8 , 3.9 , 3.8 , 3.8 , 3.5 , 3.7 , 4.0 , 4.0 ) # přímé zadání hodnot
# x <- read.table("data.txt")[, 1] # první sloupec souboru v pracovním adresáři
# x <- read.table(file.choose())[, 1] # první sloupec souboru vybraného v dialogovém okně
Řádky s načtením ze souboru jsou zakomentované znakem #, protože soubor musí ležet v pracovním adresáři R. read.table() vrací datovou tabulku (data.frame), ne vektor. Bez výběru sloupce [, 1] vrátí mean(x) hodnotu NA a shapiro.test(x) skončí chybou. Soubor s více proměnnými ve sloupcích (např. u regrese) se načte celý a sloupce se vyberou podle pořadí: d <- read.table("data.txt"), pak x <- d[, 1] a y <- d[, 2]. Soubor bez řádku se jmény sloupců dostane jména V1, V2, …; jména z prvního řádku souboru načte read.table("data.txt", header = TRUE) a sloupec se pak vybere přes $ (např. d$x).
Situace Test R volání Co odečíst z výstupu Jeden výběr, normální data — test střední hodnoty jednovýběrový t-test t.test(x, mu = ..., alternative = ...)p-value, interval spolehlivosti, mean of xJeden výběr, data nejsou normální — test mediánu jednovýběrový Wilcoxonův test wilcox.test(x, mu = c, alternative = ...)p-valuePárová měření, diference normální párový t-test t.test(x, y, paired = TRUE)p-value, mean differencePárová měření, diference nejsou normální párový Wilcoxonův test wilcox.test(x, y, paired = TRUE, mu = c)p-valueDva nezávislé výběry — shoda rozptylů (krok 1) F-test var.test(x, y)p-value → volba var.equal pro následující t-testDva nezávislé výběry, normální data — shoda středních hodnot (krok 2) dvouvýběrový t-test t.test(x, y, var.equal = TRUE/FALSE)p-value, mean of x, mean of yDva nezávislé výběry, data nejsou normální dvouvýběrový Wilcoxonův test wilcox.test(x, y)p-valueVíc než dva nezávislé výběry, data nejsou normální Kruskalův-Wallisův test kruskal.test(y ~ faktor, data)p-valueVíc než dva závislé výběry (dvojné třídění) Friedmanův test friedman.test(y ~ A | B, data)p-valueOvěření normality dat před volbou testu Shapiro-Wilkův test shapiro.test(x)p-valueShoda dat se zadaným typem rozdělení Kolmogorovův-Smirnovův test ks.test(x, "pnorm", mu, sigma)p-value
H0 se na hladině významnosti 0,05 zamítá, pokud je p-value nejvýše 0,05, a nezamítá, pokud je vyšší; nezamítnutí neznamená, že H0 platí, jen že data proti ní nejsou v rozporu. U testů normality to znamená, že normalitu dat lze předpokládat, ne že data jsou normální.
Rozdělení P ( X = k ) P(X = k) f ( x ) f(x) P ( X ≤ k ) P(X \le k) F ( x ) F(x) P ( X > k ) P(X > k) 1 − F ( x ) 1 - F(x) Kvantil x P x_P Binomické B i ( n , p ) Bi(n,p) dbinom(k, n, p)pbinom(k, n, p)pbinom(k, n, p, FALSE)qbinom(P, n, p)Poissonovo P o ( λ ) Po(\lambda) dpois(k, lambda)ppois(k, lambda)ppois(k, lambda, FALSE)qpois(P, lambda)Geometrické G ( p ) G(p) dgeom(k, p)pgeom(k, p)pgeom(k, p, FALSE)qgeom(P, p)Hypergeometrické H ( N , M , n ) H(N,M,n) dhyper(k, M, N-M, n)phyper(k, M, N-M, n)phyper(k, M, N-M, n, FALSE)qhyper(P, M, N-M, n)Normální N ( μ , σ 2 ) N(\mu,\sigma^2) dnorm(x, mu, sigma)pnorm(x, mu, sigma)pnorm(x, mu, sigma, FALSE)qnorm(P, mu, sigma)Exponenciální E ( δ ) E(\delta) dexp(x, 1/delta)pexp(x, 1/delta)pexp(x, 1/delta, FALSE)qexp(P, 1/delta)Studentovo t ( k ) t(k) dt(x, df = k)pt(x, df = k)pt(x, df = k, lower.tail = FALSE)qt(P, df = k)Pearsonovo χ 2 ( k ) \chi^2(k) dchisq(x, df = k)pchisq(x, df = k)pchisq(x, df = k, lower.tail = FALSE)qchisq(P, df = k)Fisherovo-Snedecorovo F ( k 1 , k 2 ) F(k_1,k_2) df(x, df1 = k1, df2 = k2)pf(x, df1 = k1, df2 = k2)pf(x, df1 = k1, df2 = k2, lower.tail = FALSE)qf(P, df1 = k1, df2 = k2)
Normální rozdělení se v R zadává směrodatnou odchylkou σ \sigma σ 2 \sigma^2 Exponenciální rozdělení se zadává parametrem 1/delta, kde δ \delta dgeom(k, p) počítá pravděpodobnost k k Pravý ocas vrací argument lower.tail = FALSE. Bez jména (jen FALSE) musí stát přesně na jeho pozici, tedy hned za parametry rozdělení. U t t χ 2 \chi^2 F F ncp, proto se tam lower.tail píše vždy jménem. U spojitých rozdělení je P ( X = x ) = 0 P(X = x) = 0 d* vrací hodnotu hustoty, ne pravděpodobnost. Funkce Co vrací length(x)rozsah souboru n n min(x), max(x)nejmenší a největší hodnota mean(x)výběrový průměr var(x)výběrový rozptyl sd(x)výběrová směrodatná odchylka median(x)výběrový medián (stejně jako quantile(x, 0.5, type = 6)) quantile(x, p, type = 6)výběrový p p sort(x) / sort(x, decreasing = TRUE)hodnoty seřazené vzestupně/sestupně boxplot(x)krabicový graf h <- hist(x, br = seq(38, 46, by = 1))histogram s danými hranicemi tříd; výsledek třídění v h h$counts, h$breaks, h$midsčetnosti tříd, hranice tříd, středy tříd h$densityčetnost třídy dělená n n f <- ecdf(x)empirická distribuční funkce f(k)hodnota empirické distribuční funkce v bodě k k knots(f)vzestupně seřazené různé hodnoty souboru
Funkce Použití t.test(x, mu = ..., alternative = ...)jednovýběrový t-test t.test(x, y, paired = TRUE)párový t-test t.test(x, y, var.equal = TRUE/FALSE)dvouvýběrový t-test var.test(x, y)F-test shody rozptylů shapiro.test(x)Shapiro-Wilkův test normality ks.test(x, "pnorm", mu, sigma)Kolmogorovův-Smirnovův test shody s normálním rozdělením ks.test(x, "pexp", 1/delta)Kolmogorovův-Smirnovův test shody s exponenciálním rozdělením wilcox.test(x, mu = c, alternative = ...)jednovýběrový Wilcoxonův test wilcox.test(x, y, paired = TRUE, mu = c)párový Wilcoxonův test wilcox.test(x, y)dvouvýběrový Wilcoxonův test kruskal.test(y ~ faktor, data)Kruskalův-Wallisův test library(agricolae); Median.test(y, faktor)mediánový test (alternativa ke Kruskalovu-Wallisovu) friedman.test(y ~ A | B, data)Friedmanův test (friedman.test(y, A, B) jen pro samostatné vektory)
Funkce Použití lm(y ~ x)lineární regrese (přímka) lm(y ~ x + I(x^2))parabolická regrese lm(y ~ I(1/x))hyperbolická regrese library(nls2); nls2(y ~ b1 * exp(b2 * x))exponenciální regrese y = b 1 e b 2 x y = b_1 e^{b_2 x} nls2(y ~ b1 * b2^x)regrese y = b 1 b 2 x y = b_1 b_2^{x} summary(model)odhady parametrů, jejich významnost, koeficient determinace coef(model)odhadnuté parametry b 0 , b 1 , … b_0, b_1, \dots fitted(model)predikce y ^ i \hat y_i x i x_i residuals(model)rezidua e i = y i − y ^ i e_i = y_i - \hat y_i confint(model, level = 0.95)intervaly spolehlivosti pro parametry modelu predict(model, interval = "confidence", level = 0.95)interval spolehlivosti pro střední hodnotu y ^ \hat y predict(model, interval = "prediction", level = 0.95)predikční interval pro jednotlivou hodnotu y y predict(model, newdata = data.frame(x = c(7, 8)), interval = "confidence")totéž pro nové hodnoty x x cor(x, y)korelační koeficient step(model, direction = "both")stepwise výběr proměnných podle AIC library(car); vif(model)Variance Inflation Factor (multikolinearita) library(lmtest); dwtest(model)Durbin-Watsonův test autokorelace reziduí library(whitestrap); white_test(model)Whiteův test homoskedasticity reziduí shapiro.test(residuals(model))test normality reziduí
Funkce Použití chisq.test(tab)test nezávislosti dvou kvalitativních znaků chisq.test(tab, correct = FALSE)totéž pro čtyřpolní tabulku 2 × 2 bez Yatesovy korekce, jak se počítá v kurzu chisq.test(tab)$expectedočekávané četnosti za platnosti nezávislosti sqrt(chisq.test(tab, correct = FALSE)$statistic / (sum(tab) * (min(dim(tab)) - 1)))Cramérův koeficient kontingence V V mcnemar.test(tab, correct = FALSE)McNemarův test pro párovaná kvalitativní data
Funkce Použití library(qcc)balíček pro regulační diagramy a indexy způsobilosti qcc.groups(x, sample)sestavení logických podskupin z dlouhého formátu dat qcc(data, type = "R")regulační diagram rozpětí R R data je matice, řádek = logická podskupina qcc(data, type = "xbar")regulační diagram průměrů x ˉ \bar x qcc(data, type = "S")regulační diagram výběrových směrodatných odchylek s s qcc(x, type = "xbar.one")diagram individuálních hodnot x i x_i σ \sigma qcc(c_i, type = "c")diagram počtu neshod c c qcc(u_i, type = "u", sizes = ...)diagram počtu neshod na jednotku u u sizes = rozsahy podskupin qcc(np_i, type = "np", sizes = n)diagram počtu neshodných jednotek n p np n n qcc(np_i, type = "p", sizes = ...)diagram podílu neshodných jednotek p p q <- qcc(data, type = "xbar")uložení diagramu pro výpočet indexů způsobilosti process.capability(q, spec.limits = c(LSL, USL), target = T, std.dev = sd(data))indexy C p C_p C p k C_{pk} C p m C_{pm}
Parametr Výchozí hodnota v R Co se změní při jiném nastavení correct v mcnemar.test()TRUE (Yatesova korekce na kontinuitu)correct = FALSE odpovídá nekorigovanému vzorci počítanému v kurzu ručněcorrect v chisq.test()TRUE, uplatní se jen u tabulky 2 × 2correct = FALSE dá hodnotu vzorce pro čtyřpolní tabulku z kurzuvar.equal v t.test()FALSE (Welchova varianta)TRUE použije klasickou dvouvýběrovou statistiku se společným rozptylem — volí se podle výsledku F-testualternative v t.test() / wilcox.test() / var.test()"two.sided""greater" / "less" testuje jednostrannou alternativu — musí odpovídat formulaci H 1 H_1 paired v t.test() / wilcox.test()FALSETRUE testuje dvojice závislých měření (diference), ne dva nezávislé výběryconf.level v t.test() / var.test()0.95určuje spolehlivost intervalu uvedeného ve výstupu testu (1 − α 1 - \alpha conf.int v wilcox.test()FALSEwilcox.test() vypíše interval spolehlivosti jen s conf.int = TRUE; samotné conf.level výstup nezměnítype v quantile()7type = 6 odpovídá ručnímu výpočtu kvantilů použitému v kurzuright v hist()TRUE (třídy zleva otevřené, zprava uzavřené)right = FALSE otočí hranice tříd na zleva uzavřené, zprava otevřenéplot v qcc()TRUE (diagram se vykreslí)plot = FALSE jen spočítá meze a vrátí objekt bez vykreslení grafustd.dev v process.capability()směrodatná odchylka z regulačního diagramu q (z rozpětí nebo směrodatných odchylek v podskupinách) std.dev = sd(data) použije výběrovou směrodatnou odchylku všech dat; indexy vyjdou jinaktarget v process.capability()střed tolerance ( L S L + U S L ) / 2 (LSL + USL)/2 jiná cílová hodnota T T C p m C_{pm}
KROPÁČ, J. Statistika A . 4. vyd. Brno: Fakulta podnikatelská VUT, 2011.
MONTGOMERY, D. C. Introduction to Statistical Quality Control . 6. vyd. Hoboken: Wiley, 2009.
KUPKA, K. Statistické řízení jakosti . Pardubice: TriloByte, 1997.