
Regresní a korelační analýza
Regresní a korelační analýza
Základní pojmy
Metody aplikované statistiky pracuje se dvěma znaky a zjištěnými na stejných jednotkách. Regresní analýza se zabývá jednostrannými závislostmi, kdy proti sobě stojí vysvětlující (nezávisle) proměnná v úloze příčiny a vysvětlovaná (závisle) proměnná v úloze následku. Korelační analýza se zabývá vzájemnými, většinou lineárními závislostmi; důraz je kladen na intenzitu vztahu. Oba přístupy se v praxi prolínají — nejdřív se zvolí a odhadne regresní funkce, pak se její kvalita vyjádří korelační charakteristikou.
Hlavním úkolem obou analýz je přispět k poznání vztahů mezi znaky — podat matematický popis systematických okolností, které závislost provázejí, a nalézt funkci, která nejlépe vystihuje její charakter (regresní funkce).
Druh regresní analýzy určuje struktura datového souboru:
- dvourozměrný datový soubor (jedna , jedna ) → regresní analýza dvou proměnných,
- vícerozměrný datový soubor (více ) → vícenásobná regresní analýza.
Volba konkrétní regresní funkce by měla vycházet jak z ekonomické teorie (ta napovídá, zda závislost roste, nebo klesá, zda je přímková, nebo zakřivená), tak z grafické a matematicko-statistické analýzy dat — oba přístupy je vhodné kombinovat.
Metoda nejmenších čtverců
Rozlišují se teoretická regresní funkce — neznámá, populační, daná neznámými parametry — a empirická regresní funkce , jejíž odhadnuté parametry jsou odhadem vypočteným z konkrétních dat. Odchylky skutečných hodnot od empirické funkce, , se nazývají rezidua.
Nejpoužívanější metodou odhadu parametrů je metoda nejmenších čtverců (OLS): hledají se takové parametry, pro které je součet čtverců reziduí minimální,
Odhad probíhá ve čtyřech krocích: (1) posoudit dostupné informace o charakteru závislosti, (2) navrhnout jeden nebo víc typů regresních funkcí, (3) odhadnout jejich parametry metodou nejmenších čtverců, (4) porovnat vhodnost odhadnutých funkcí a při neuspokojivém výsledku zvolit jiný typ.
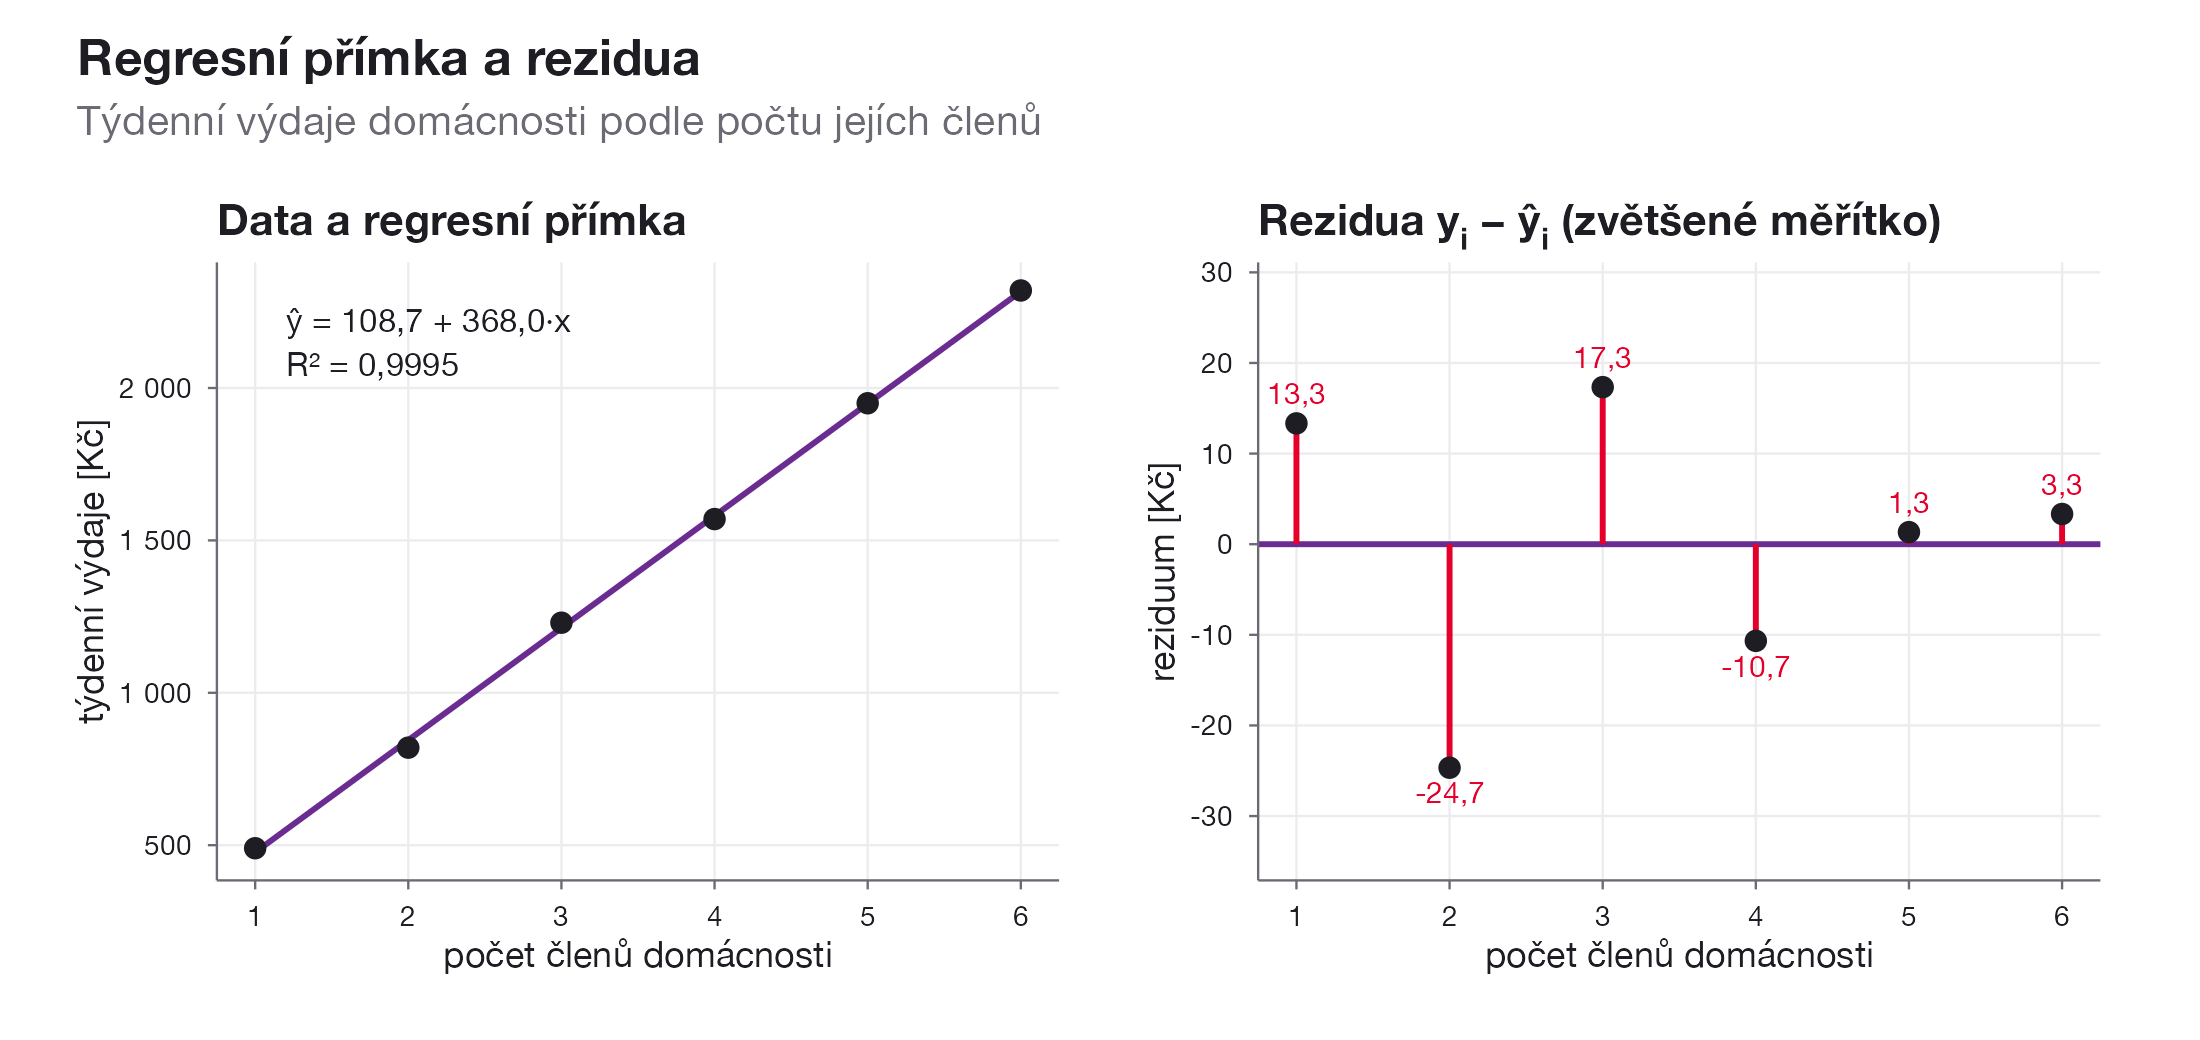
Obrázek ukazuje přesně to, co metoda minimalizuje: délky červených úseček jsou rezidua , metoda nejmenších čtverců volí přímku tak, aby součet jejich čtverců byl nejmenší možný.
Regresní přímka
Nejjednodušší regresní funkcí je regresní přímka:
Koeficient udává změnu průměru při jednotkové změně ; jeho znaménko určuje, zda je závislost přímá, nebo nepřímá.
V R
Vstupní data se nahrají buď ze souboru (d <- read.table("data.txt"), případně d <- read.table(file.choose())), nebo zapíší přímo jako vektory. Na šesti domácnostech sledujeme počet členů domácnosti a jejich týdenní výdaje:
pocet_clenu <- c(1, 2, 3, 4, 5, 6)
tydenni_vydaje <- c(490, 820, 1230, 1570, 1950, 2320)
model <- lm(tydenni_vydaje ~ pocet_clenu)
summary(model)
Call:
lm(formula = tydenni_vydaje ~ pocet_clenu)

Residuals:
      1       2       3       4       5       6
 13.333 -24.667  17.333 -10.667   1.333   3.333

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  108.667     16.214   6.702  0.00258 **
pocet_clenu  368.000      4.163  88.391 9.82e-08 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 17.42 on 4 degrees of freedom
Multiple R-squared:  0.9995,    Adjusted R-squared:  0.9994
F-statistic:  7813 on 1 and 4 DF,  p-value: 9.821e-08
Odhadnutý model je . Sloupec Pr(>|t|) je p-hodnota t-testu proti pro každý parametr — obě p-hodnoty jsou hluboko pod 0,05, oba parametry jsou tedy statisticky významné. Multiple R-squared je index determinace : model vysvětluje 99,95 % rozptylu výdajů.
Pro doplňkový přehled slouží přímé přístupové funkce:
coef(model)
fitted(model)
residuals(model)
(Intercept) pocet_clenu
   108.6667    368.0000
        1         2         3         4         5         6
 476.6667  844.6667 1212.6667 1580.6667 1948.6667 2316.6667
         1          2          3          4          5          6
 13.333333 -24.666667  17.333333 -10.666667   1.333333   3.333333
coef() vrací odhadnuté parametry , fitted() predikce pro pozorované , residuals() rezidua — stejná čísla, která na obrázku výše tvoří délky červených úseček.
Intervaly spolehlivosti pro parametry a pro predikci v nových bodech (zde 7 a 8 členů domácnosti):
confint(model, level = 0.95)
nove <- data.frame(pocet_clenu = c(7, 8))
predict(model, newdata = nove, interval = "confidence", level = 0.95)
predict(model, newdata = nove, interval = "prediction", level = 0.95)
                2.5 %   97.5 %
(Intercept)  63.64981 153.6835
pocet_clenu 356.44074 379.5593
       fit     lwr      upr
1 2684.667 2639.65 2729.684
2 3052.667 2997.03 3108.303
       fit      lwr      upr
1 2684.667 2618.600 2750.733
2 3052.667 2978.953 3126.381
interval = "confidence" dává interval spolehlivosti pro střední hodnotu při daném , interval = "prediction" širší interval pro jednotlivé budoucí pozorování — ten musí zahrnout i rozptyl kolem regresní přímky, proto je vždy širší.
Diagnostika modelu
Platnost závěrů z regresní přímky stojí na předpokladech o reziduích: absenci autokorelace, stálosti rozptylu (homoskedasticitě) a normalitě. V R se ověřují takto:
library(lmtest)
dwtest(model)
    Durbin-Watson test

data:  model
DW = 3.4121, p-value = 0.9555
alternative hypothesis: true autocorrelation is greater than 0
Durbinův–Watsonův test má : v modelu není problém s autokorelací, proti : v modelu problém s autokorelací je. Statistika DW se pohybuje mezi 0 a 4, hodnota blízko 2 znamená žádnou autokorelaci. Zde p-hodnota 0,96 je výrazně nad 0,05, se nezamítá.
library(whitestrap)
white_test(model)
White's test results

Null hypothesis: Homoskedasticity of the residuals
Alternative hypothesis: Heteroskedasticity of the residuals
Test Statistic: 3.14
P-value: 0.207817
Whiteův test má : rozptyl reziduí je stálý (homoskedasticita), proti : rozptyl není stálý (heteroskedasticita). P-hodnota 0,21 je nad 0,05, se nezamítá.
shapiro.test(residuals(model))
    Shapiro-Wilk normality test

data:  residuals(model)
W = 0.94818, p-value = 0.7255
Shapiro–Wilkův test má : rezidua pocházejí z normálního rozdělení. P-hodnota 0,73 opět nevede k zamítnutí — všechny tři předpoklady model splňuje.
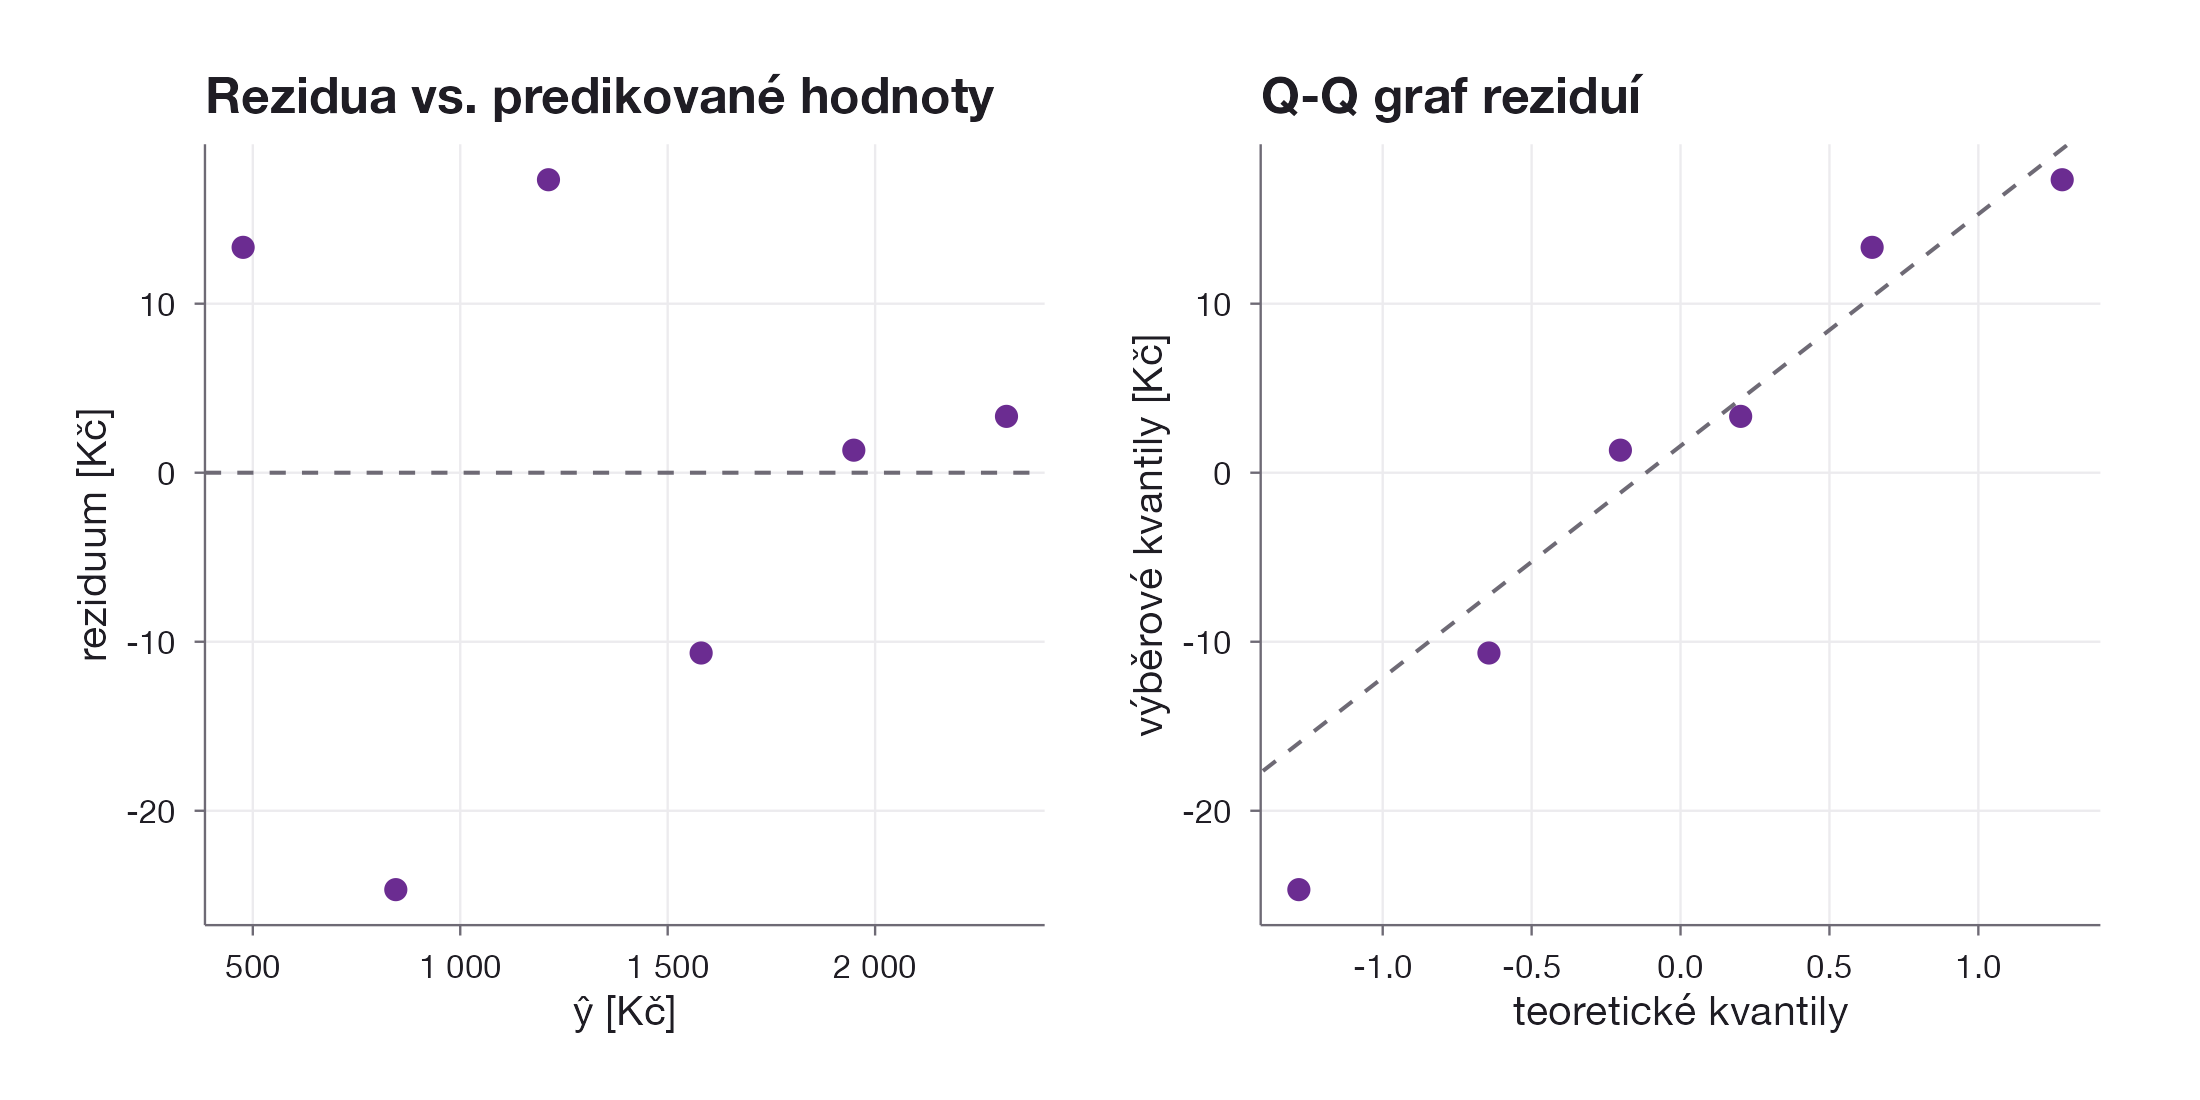
Grafická kontrola normality doplňuje Shapiro–Wilkův test: body v levém panelu by měly být rovnoměrně rozptýlené po obou stranách vodorovné osy (bez trychtýře či oblouku), body v Q-Q grafu by měly ležet kolem přímky. U malého počtu pozorování se dává přednost testu; u velkého datového souboru se předpoklad normality reziduí stává méně kritickým díky centrální limitní větě.
Nelineární a vyšší řády regresních funkcí
Když přímka závislost nevystihuje, nabízí se další lineární funkce — tedy funkce lineární ve svých parametrech, zapsatelné ve tvaru se známými funkcemi a neznámými parametry . I tyto parametry se odhadují metodou nejmenších čtverců, stejně jako u přímky:
Naproti tomu nelineární funkce nelze do tvaru převést — je nelineární i ve svých parametrech. Jejich parametry nelze získat přímo metodou nejmenších čtverců, ale vhodnou transformací nebo iterativně. Základní příklad je exponenciální regrese:
V R — parabolická regrese
Na ročních ziscích firmy (šest let) se parabolická regrese odhadne přidáním kvadratického členu I(x^2):
rok <- c(1, 2, 3, 4, 5, 6)
zisk <- c(112, 149, 238, 354, 580, 867)
model_parabola <- lm(zisk ~ rok + I(rok^2))
summary(model_parabola)
Call:
lm(formula = zisk ~ rok + I(rok^2))

Residuals:
      1       2       3       4       5       6
 -8.071   9.243  14.343 -17.771  -4.100   6.357

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  164.600     27.892   5.901  0.00972 **
rok          -76.636     18.248  -4.200  0.02464 *
I(rok^2)      32.107      2.552  12.582  0.00108 **
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 15.59 on 3 degrees of freedom
Multiple R-squared:  0.9983,    Adjusted R-squared:  0.9971
F-statistic: 868.7 on 2 and 3 DF,  p-value: 7.156e-05
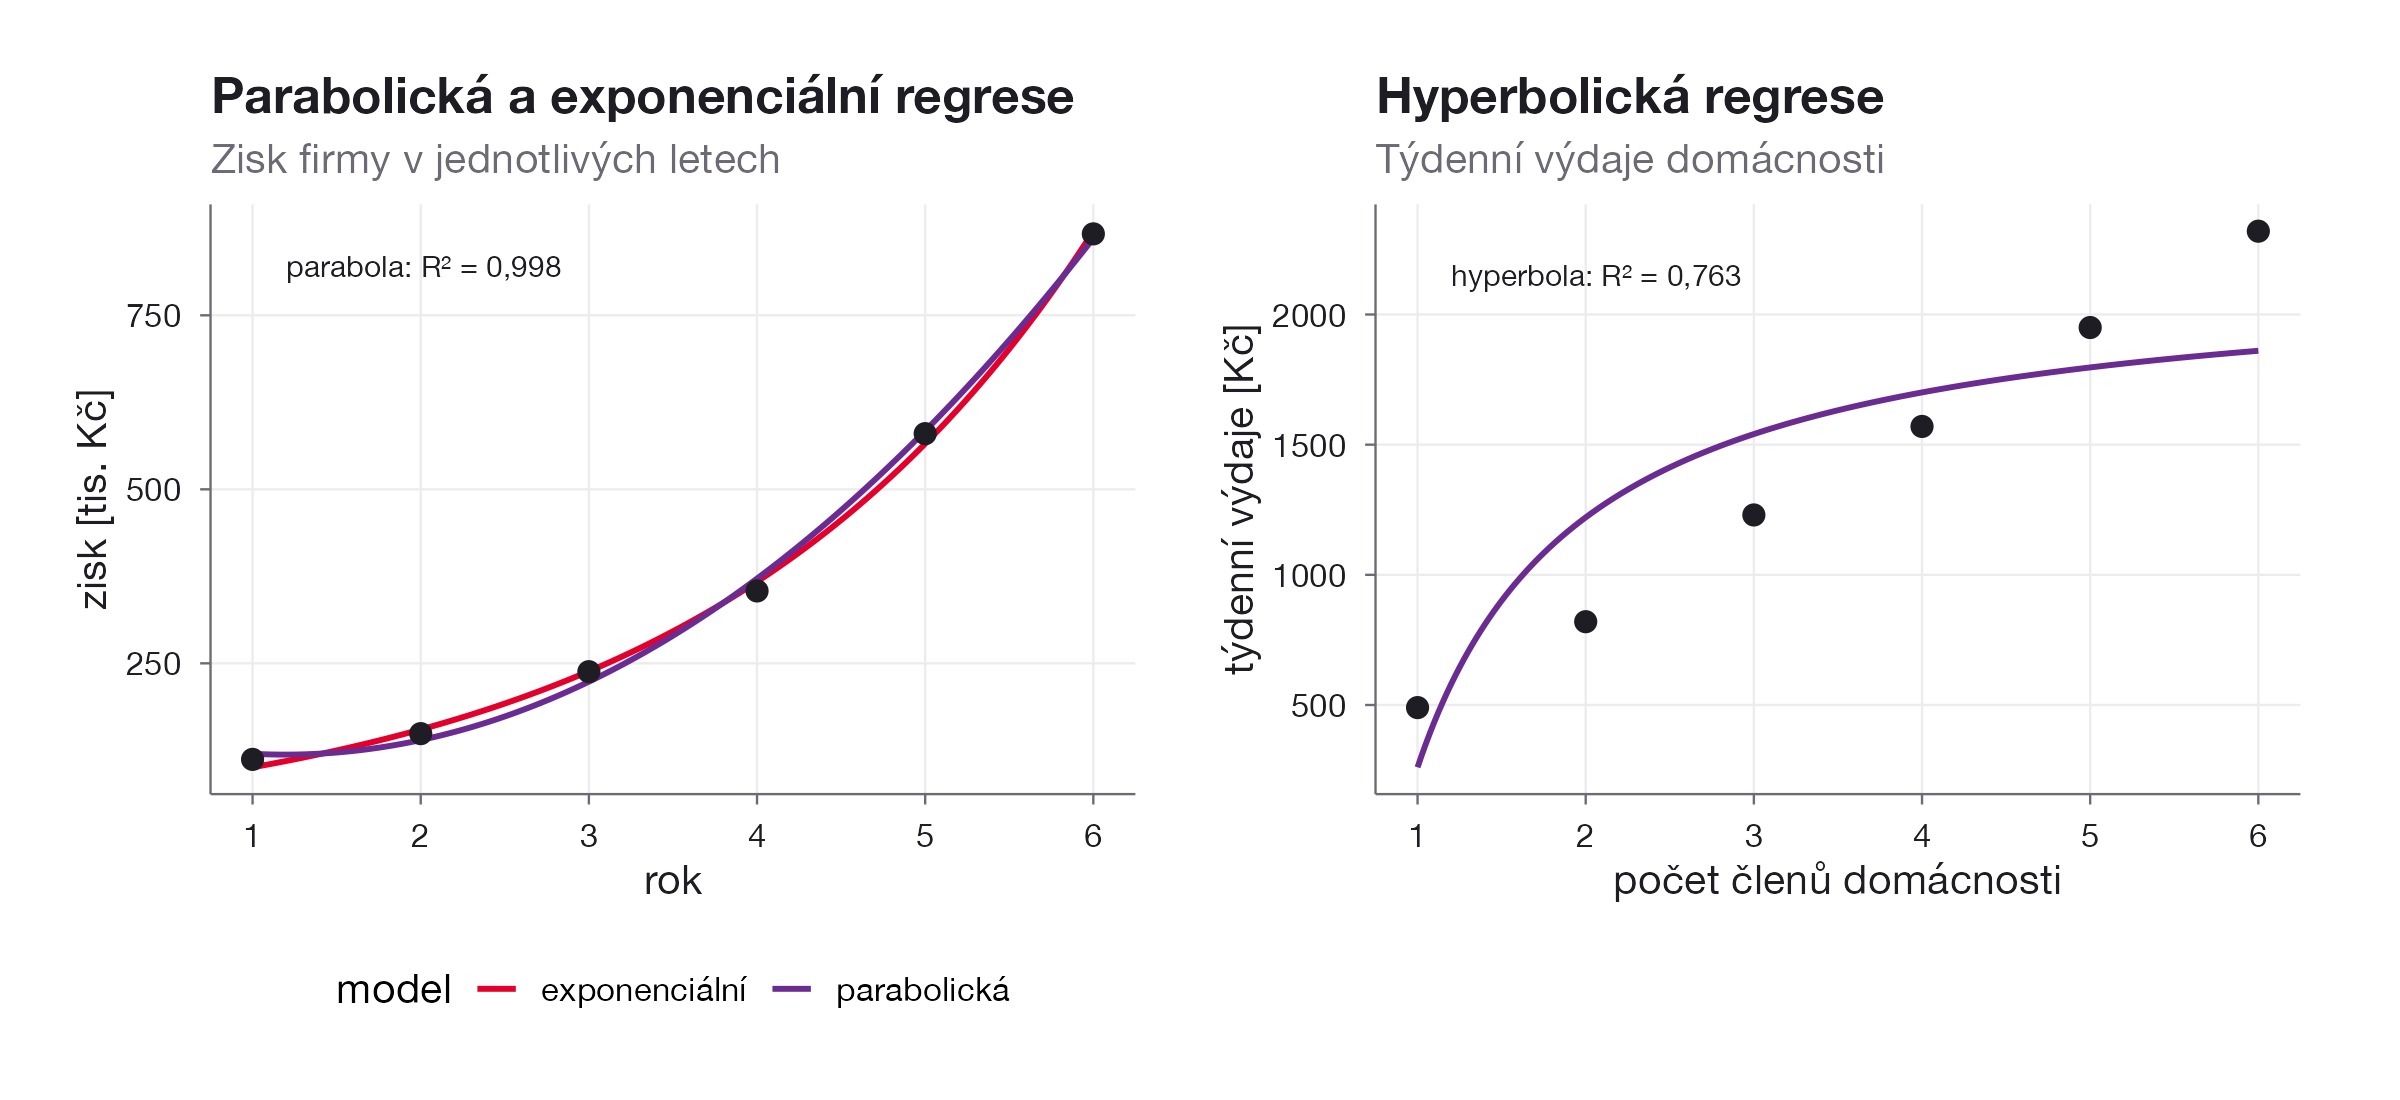
Odhadnutá parabola vysvětluje 99,8 % rozptylu zisku — podstatně víc, než by vysvětlila přímka proložená stejně rostoucími daty.
V R — exponenciální regrese
Nelineární funkce se v R odhadují funkcí nls2() ze stejnojmenného balíčku. Bez zadaných počátečních hodnot R upozorní, že parametry nastavil na 1, a odhad dopočítá iteračně:
library(nls2)
model_exp <- nls2(zisk ~ b1 * exp(b2 * rok))
summary(model_exp)
Formula: zisk ~ b1 * exp(b2 * rok)

Parameters:
   Estimate Std. Error t value Pr(>|t|)
b1 65.35423    3.57542   18.28 5.27e-05 ***
b2  0.43161    0.01013   42.63 1.81e-06 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 11.89 on 4 degrees of freedom
Stejnou křivku lze zapsat i v mocninném tvaru :
model_pow <- nls2(zisk ~ b1 * (b2^rok))
summary(model_pow)
Formula: zisk ~ b1 * (b2^rok)

Parameters:
   Estimate Std. Error t value Pr(>|t|)
b1 65.35424    3.57542   18.28 5.27e-05 ***
b2  1.53973    0.01559   98.76 6.30e-08 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 11.89 on 4 degrees of freedom
Obě varianty popisují stejnou křivku (, zde ) a mají totožnou reziduální chybu — je to jen otázka parametrizace.
V R — hyperbolická regrese
Hyperbolická regrese se odhadne jako obyčejná lineární regrese na transformované proměnné I(1/x):
model_hyperbola <- lm(tydenni_vydaje ~ I(1 / pocet_clenu))
summary(model_hyperbola)
Call:
lm(formula = tydenni_vydaje ~ I(1/pocet_clenu))

Residuals:
     1      2      3      4      5      6
 229.3 -400.7 -310.7 -130.7  153.3  459.3

Coefficients:
                 Estimate Std. Error t value Pr(>|t|)
(Intercept)        2180.7      266.5   8.182  0.00122 **
I(1/pocet_clenu)  -1920.0      534.6  -3.592  0.02293 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 374.6 on 4 degrees of freedom
Multiple R-squared:  0.7633,    Adjusted R-squared:  0.7041
F-statistic:  12.9 on 1 and 4 DF,  p-value: 0.02293
Model vysvětluje jen 76,3 % rozptylu — u těchto dat je hyperbola podstatně horší volbou než přímka (). Právě k takovému porovnání slouží index determinace: nízká hodnota signalizuje, že zvolený typ funkce k datům nesedí.
Kvalita regresní funkce a korelační analýza
Kvalitu odhadnuté regresní funkce vyjadřuje index determinace:
Čím blíž je k 1, tím silnější je závislost; v procentech udává, jakou část rozptylu závisle proměnné se podařilo vysvětlit zvolenou regresní funkcí. Nízký index determinace může signalizovat špatně zvolený typ regresní funkce, ne nutně absenci závislosti.
Obecnou mírou těsnosti závislosti — platnou pro libovolný typ regresní funkce — je index korelace . Je-li zvolenou funkcí regresní přímka, index korelace je roven (až na znaménko) koeficientu korelace:
Koeficient korelace nabývá hodnot od do : znaménko určuje typ závislosti (pozitivní, nebo negativní), absolutní hodnota její sílu — čím blíž k 0, tím je závislost slabší.
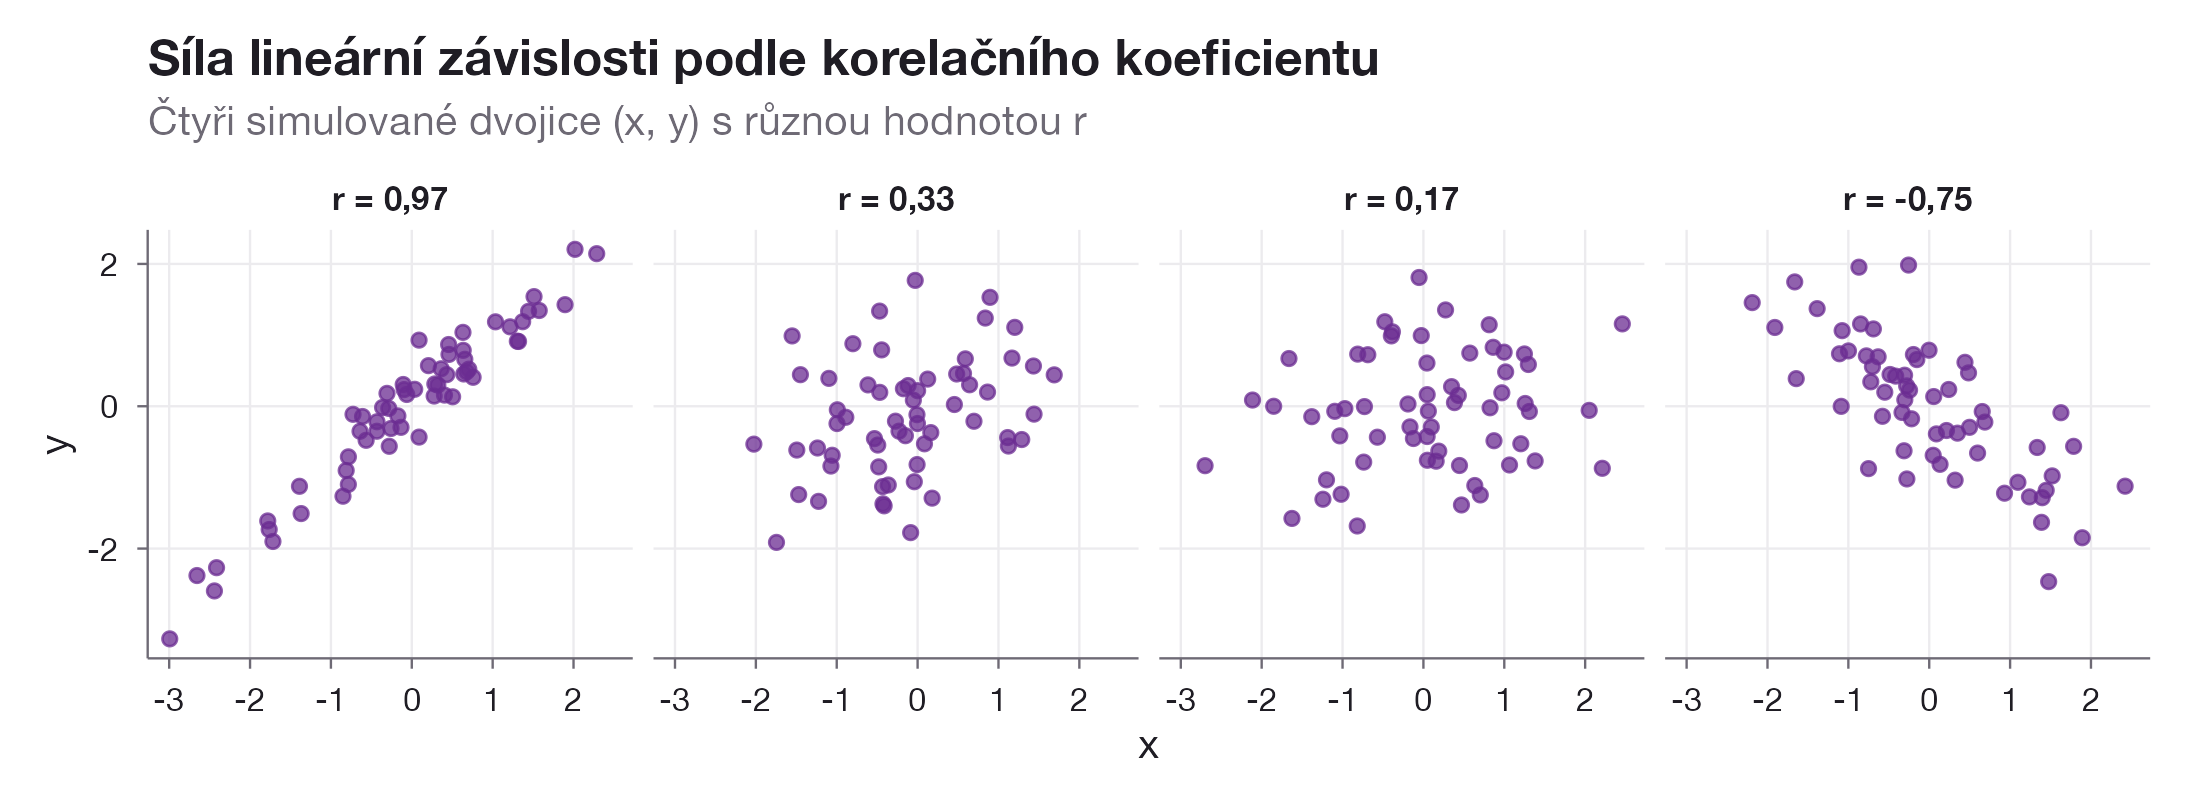
S rostoucí absolutní hodnotou se body v rozptylovém grafu víc blíží přímce; kolem je mezi a patrná jen náhodná rozptýlenost bez lineárního trendu.
V R
cor(pocet_clenu, tydenni_vydaje)
[1] 0.9997441
Hodnota 0,9997 odpovídá ze summary regresní přímky výše — přesně tak, jak definice říká: pro přímkovou regresi je koeficient korelace roven indexu korelace.
Vícenásobná regrese a korelace
Pokud na závisle proměnnou působí víc vysvětlujících proměnných současně, analyzuje se zvlášť vliv každé z nich a výsledná regresní funkce se konstruuje jako součet jednoduchých regresních funkcí:
Výběr proměnných
- Metoda ENTER — vloží do modelu všechny proměnné najednou. Použije se, když jde o index determinace celého modelu, o vliv každé nezávislé proměnné při kontrole vlivu ostatních, nebo o relativní důležitost proměnných. Vyžaduje poměrně vysoký počet pozorování — aspoň 20 na každou proměnnou.
- Metoda stepwise (postupná regrese) — hledá „nejlepší" model (co nejmíň proměnných, co nejkvalitnější predikce) na základě F-testu; pořadí vstupu/odebrání proměnných řídí program, ne uživatel. Varianta forward proměnné postupně přidává, varianta backward naopak začíná plným modelem a proměnné postupně odebírá. Pořadí vkládání ovlivňuje odhad důležitosti proměnných, proto je třeba metodu zvolit uvážlivě. Stepwise vyžaduje ještě víc pozorování — aspoň 40 na proměnnou.
Postup odhadu
- ověření předpokladů regresního modelu,
- samotný odhad parametrů,
- reziduální analýza výsledného modelu.
Důležitost každého parametru v modelu ověřuje t-test: (proměnná je v modelu nevýznamná) proti (proměnná je významná). Při nezamítnutí by proměnná — a s ní spojený regresor — v modelu neměla zůstat.
Předpoklady modelu
- Závisle proměnná musí být aspoň intervalového typu (ne binární, diskrétní s málo hodnotami apod.) — jinak je na místě logistická regrese.
- Nezávislé proměnné jsou rovněž aspoň intervalového typu, mohou být i alternativní.
- Nezávislé proměnné by mezi sebou neměly být příliš vysoce korelované — multikolinearita.
- V datech nesmí být odlehlé či extrémní hodnoty; regresní analýza je na ně citlivá a mohou vážně narušit kvalitu odhadů.
- Proměnné musí být ve vzájemně lineárním vztahu — vícenásobná lineární regrese je založená na Pearsonově koeficientu korelace, takže nelineární vztahy mezi proměnnými zůstanou neodhalené.
- Proměnné mají mít normální rozložení; význam tohoto předpokladu ustupuje do pozadí u dostatečně velkého datového souboru díky centrální limitní větě.
Normalita se u menšího počtu pozorování ověřuje stejnými testy jako u jiných znaků (viz testování statistických hypotéz) — Shapiro–Wilkovým nebo Kolmogorovovým–Smirnovovým testem — nebo graficky grafem reziduí proti predikovaným hodnotám, kde by body měly být rovnoměrně rozptýlené po obou stranách vodorovné osy.
Multikolinearita
Multikolinearita vzniká, když vysvětlující proměnné silně závisejí jedna na druhé. Je nežádoucí, protože:
- výsledky regrese jsou pak nespolehlivé,
- zvyšuje pravděpodobnost, že se důležitá proměnná jeví jako statisticky nevýznamná a bude z modelu vyřazena,
- směrodatné odchylky odhadnutých parametrů jsou vysoké, testová kritéria t-testů nízká, p-hodnoty vysoké.
Pozná se podle vysokých korelačních koeficientů mezi regresory (nad 0,75), podle toho, že celkový F-test modelu je významný, ale jednotlivé t-testy parametrů ne, nebo softwarově přes VIF (Variance Inflation Factor): hodnoty jsou varující, (přísněji ) značí vysokou multikolinearitu.
Řešení: je-li multikolinearita způsobená silnou závislostí dvou proměnných, jednu z nich se z modelu vyřadí; je-li způsobená závislostí víc proměnných najednou, použije se metoda hlavních komponent a pracuje se s novými, nekorelovanými proměnnými.
Další ukazatele kvality modelu
- F-test — testuje hypotézu, že všechny regresní koeficienty jsou rovny nule, proti alternativě, že aspoň jeden v modelu být má (celková významnost modelu).
- RMSE (odmocnina z reziduálního rozptylu) — absolutní měřítko vhodnosti funkce (na rozdíl od indexu determinace, který je relativní); nižší hodnota znamená lepší fit.
- AIC (Akaikeho informační kritérium) a BIC (Bayesovo informační kritérium) — čím nižší hodnoty obou kritérií, tím lepší model; používají se hlavně při stepwise výběru proměnných.
V R
Pro vícenásobnou regresi je postup v R rozšířením postupu pro regresní přímku — přibývá výběr proměnných a kontrola multikolinearity:
data <- read.table("4_4.txt", header = TRUE)
model_plny <- lm(y ~ x1 + x2 + x3 + x4, data = data)
model_krok <- step(model_plny, direction = "both")
summary(model_krok)

library(car)
vif(model_krok)

library(lmtest)
dwtest(model_krok)

library(whitestrap)
white_test(model_krok)

shapiro.test(residuals(model_krok))
step() provádí stepwise výběr podle AIC, vif() spočítá Variance Inflation Factor pro každý regresor v modelu, zbylé tři volání ověřují stejné tři předpoklady (autokorelace, homoskedasticita, normalita reziduí) jako u regresní přímky výše.
Časté chyby
Související stránky
- Metody aplikované statistiky
- Náhodné veličiny a rozdělení pravděpodobnosti
- Popisná statistika a datové soubory
- Testování statistických hypotéz
- Kontingenční tabulky
- Regulační diagramy a indexy způsobilosti
- Tahák pro R
Reference
KROPÁČ, J. Statistika A. 4. vyd. Brno: Fakulta podnikatelská VUT, 2011.